


1. Relation à savoir reconstruire.
DiD = (T_après − T_avant) − (C_après − C_avant)Comparer « avant/après » sans groupe de contrôle confond souvent effet de la politique et tendance générale.
Niveau avancé
Dossier explicatif : Passer de « deux choses bougent ensemble » à « l’une a causé l’autre » : , , expérimentation et méthodes quasi-ex
Passer de « deux choses bougent ensemble » à « l’une a causé l’autre » : contrefactuel, biais de sélection, expérimentation et méthodes quasi-expérimentales.
Pour aborder « Causalité économétrie et lecture des données » sans prérequis caché, vérifiez ces acquis. Chaque lien ouvre directement le rappel utile du Module 0.
Rappel local : Une corrélation décrit une association ; une causalité demande un contrefactuel crédible. Avant tout modèle, formulez ce qui se serait passé sans traitement et quelles hypothèses permettent de l’approcher avec les données observées.
δ = (Y_T,après − Y_T,avant) − (Y_C,après − Y_C,avant)
Lecture à voix haute : « delta égale évolution du groupe traité moins évolution du groupe de comparaison entre avant et après »
| Symbole ou grandeur | Signification | Unité |
|---|---|---|
δ | delta : effet estimé par différences de différences | unité de Y |
Y_T,après | résultat moyen du groupe traité après | unité de Y |
Y_T,avant | résultat moyen du groupe traité avant | unité de Y |
Y_C,après | résultat moyen du groupe contrôle après | unité de Y |
Y_C,avant | résultat moyen du groupe contrôle avant | unité de Y |
Calcul guidé, sans saut :
Interprétation et limite : Sans tendances parallèles crédibles, absence de traitements concomitants et composition comparable, δ n’est pas automatiquement causal. Les erreurs standards doivent aussi respecter la structure des données.
Une corrélation indique que deux variables évoluent ensemble ; elle ne dit pas pourquoi. Pour parler de causalité, il faut comparer ce qui s’est produit à ce qui se serait produit sans l’intervention. Ce second monde est le contrefactuel et n’est jamais directement observable pour la même unité au même moment.
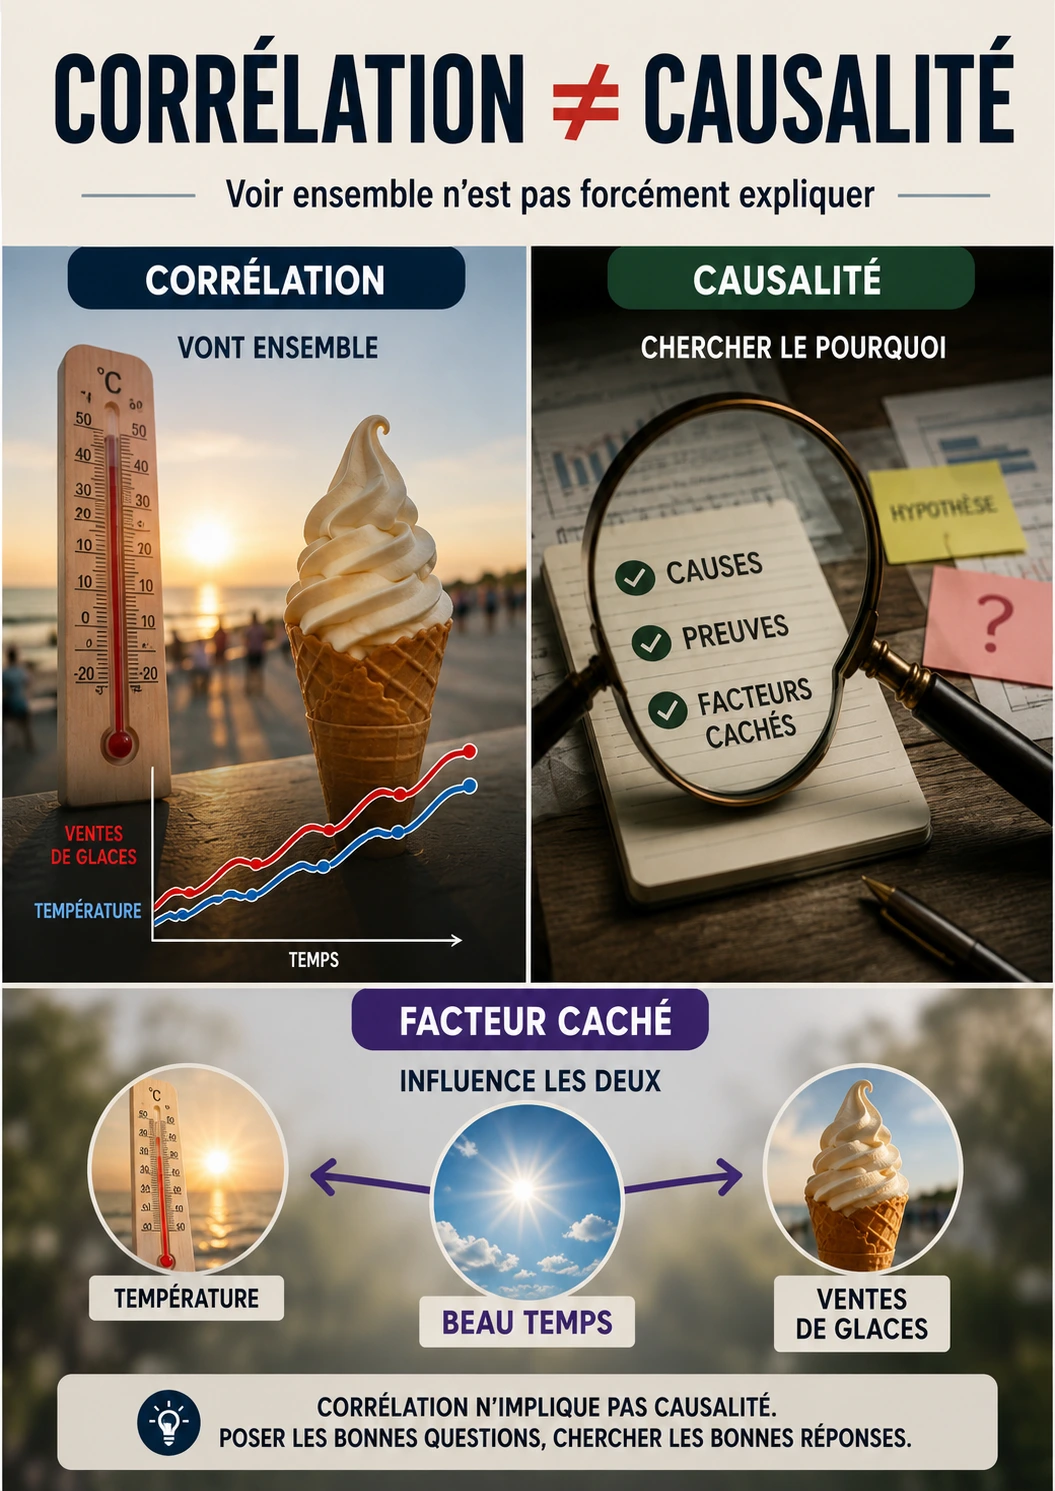
L’économétrie causale cherche donc des comparaisons crédibles : tirage aléatoire, seuil d’éligibilité, choc extérieur, calendrier décalé ou groupes dont les tendances étaient comparables. La technique mathématique vient après la qualité du dessin d’identification.
Le contrefactuel est le résultat qu’aurait connu l’unité traitée en l’absence du traitement.
Le biais de sélection apparaît lorsque les personnes ou territoires traités diffèrent systématiquement des non-traités d’une manière liée au résultat.
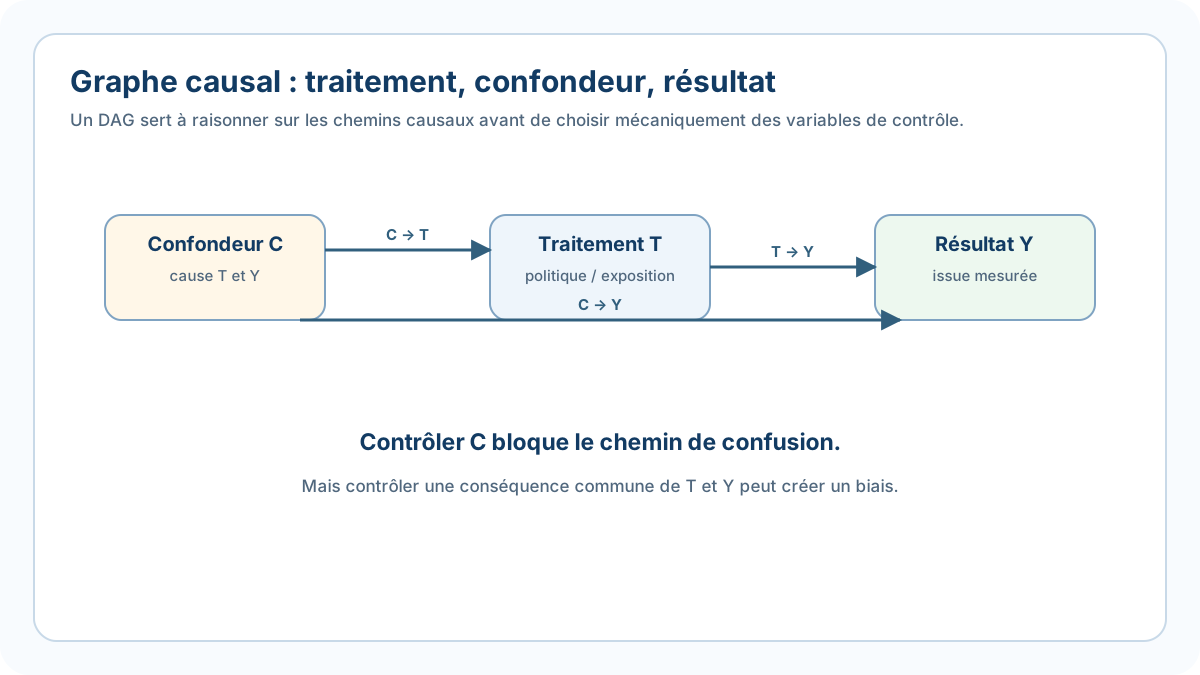
Une variable confondante influence à la fois le traitement et le résultat, créant une association qui peut être attribuée à tort au traitement.
Dans une expérience randomisée, l’assignation aléatoire vise à rendre les groupes comparables en avant le traitement. L’écart moyen après intervention peut alors être interprété causalement sous les conditions du protocole.
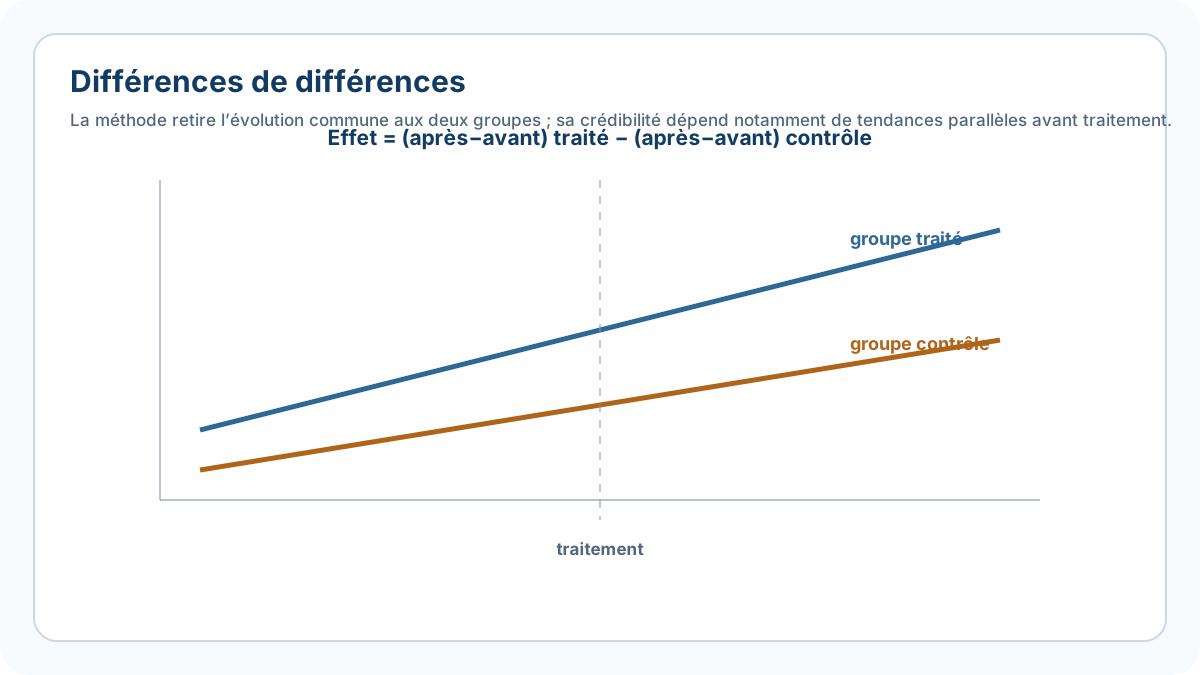
Lorsque la randomisation est impossible, une différence de différences compare l’évolution d’un groupe traité à celle d’un groupe témoin. L’hypothèse clé est que, sans traitement, leurs tendances auraient été parallèles.
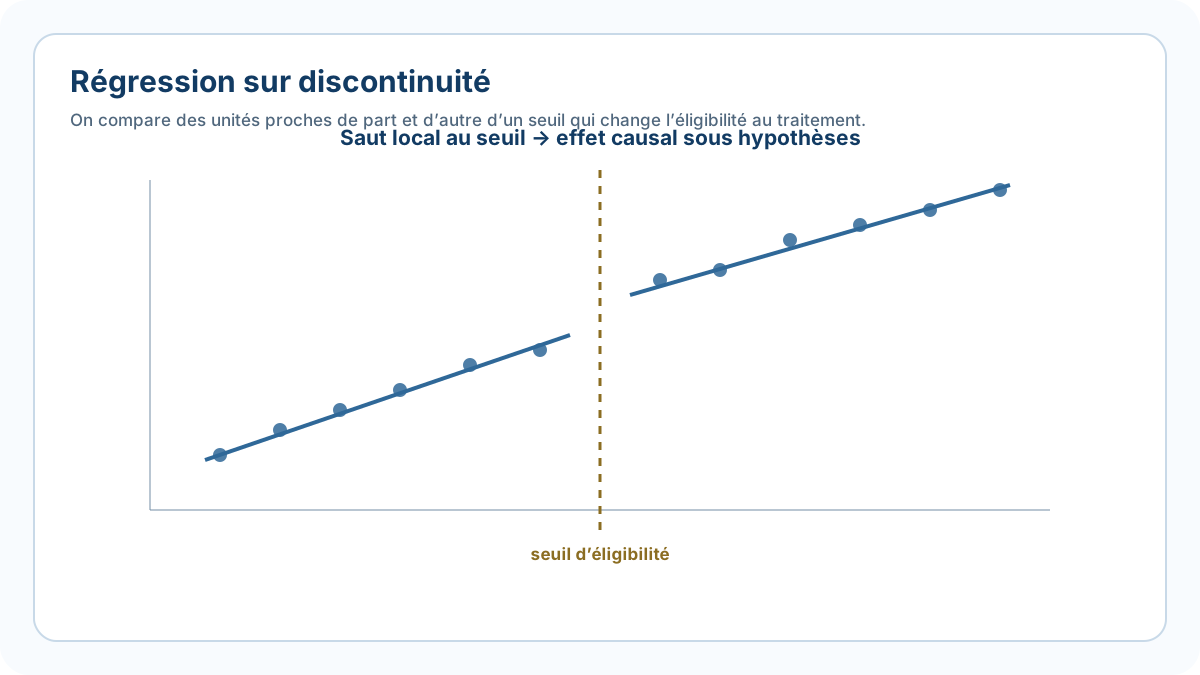
Une régression sur discontinuité exploite un seuil : juste de part et d’autre du seuil, les unités peuvent être comparables sauf pour l’accès au traitement. La crédibilité dépend notamment de l’impossibilité de manipuler précisément la variable de classement.
Les variables instrumentales utilisent une source de variation qui modifie le traitement sans agir sur le résultat par un autre canal. Cette condition d’ est exigeante et doit être argumentée institutionnellement, pas seulement par une statistique.
Une ville met en place une aide à l’ quand son chômage est déjà élevé. Après un an, le chômage baisse de 2 points. Sans groupe témoin, impossible de savoir quelle part vient de l’aide, d’une reprise nationale ou d’un retour mécanique après un choc.
Si une ville comparable sans aide baisse de 1,5 point sur la même période et si l’hypothèse de est plausible, la différence de différences suggère un effet de −0,5 point : (−2) − (−1,5) = −0,5.
Au niveau débutant, apprenez à demander : quel serait le résultat sans la mesure ?
Au niveau intermédiaire, identifiez sélection, confondants et groupes comparables avant de regarder la significativité statistique.
Au niveau avancé, discutez hypothèses d’identification, erreurs standards, hétérogénéité des effets, validité externe, pré-tendances et analyses de .
Une expérience randomisée peut mesurer un effet local dans un contexte qui ne se généralise pas à tout le pays.
Une méthode quasi-expérimentale repose sur des hypothèses non testables parfaitement ; les tests de robustesse ne transforment pas une hypothèse fragile en certitude.
La significativité statistique ne mesure ni l’importance économique ni la qualité des données. Un effet minuscule peut être très significatif dans un énorme échantillon.
Observer que X et Y évoluent ensemble ne suffit pas à conclure que X cause Y. La causalité demande un contrefactuel : que serait-il arrivé au même groupe sans le traitement ? Comme ce monde n’est pas observable, on cherche une comparaison crédible.
Une régression peut contrôler des variables observées mais elle ne corrige pas automatiquement une variable confondante non mesurée, une causalité inverse ou une sélection. Le dessin d’identification vient avant la sophistication du logiciel.
δ = (Y_T,après − Y_T,avant) − (Y_C,après − Y_C,avant)
Lecture à voix haute. « delta égale évolution du groupe traité moins évolution du groupe de comparaison entre avant et après ».
| Symbole | Ce qu’il représente | Unité ou convention |
|---|---|---|
δ | delta : effet estimé par différences de différences | unité de Y |
Y_T,après | résultat moyen du groupe traité après | unité de Y |
Y_T,avant | résultat moyen du groupe traité avant | unité de Y |
Y_C,après | résultat moyen du groupe contrôle après | unité de Y |
Y_C,avant | résultat moyen du groupe contrôle avant | unité de Y |
Contrôle rapide. On soustrait d’abord dans le temps à l’intérieur de chaque groupe, puis on soustrait les deux évolutions ; mélanger l’ordre change le sens.
Limite à connaître. Sans tendances parallèles crédibles, absence de traitements concomitants et composition comparable, δ n’est pas automatiquement causal. Les erreurs standards doivent aussi respecter la structure des données.
Pour chaque étude, écrivez : traitement, résultat, population, groupe de comparaison, date, hypothèse d’identification et menace principale. Ensuite seulement regardez coefficient, , et .
Randomisation, différences de différences, discontinuité, variables instrumentales et panels reposent sur des hypothèses distinctes. Une estimation précise d’un effet mal identifié reste précisément fausse.
Correction raisonnée. La correction est complète si vous formulez d'abord la question causale et le contrefactuel, distinguez association et effet de traitement, explicitez les hypothèses de la méthode choisie, puis interprétez coefficient, incertitude et validité externe sans confondre significativité et importance économique.
Correction expliquée : Non. Une évolution conjointe établit une corrélation, pas une causalité. Un facteur tiers, une causalité inverse ou une tendance commune peuvent expliquer le mouvement ; il faut construire un contrefactuel crédible.
Correction expliquée : Le groupe traité varie de 10 à 8, soit −2. Le témoin varie de 9 à 8,5, soit −0,5. La différence-de-différences est donc −2 − (−0,5) = −1,5. L’interprétation causale exige ensuite l’hypothèse de tendances parallèles.
Correction : Les volontaires peuvent être plus motivés ou différents avant le programme.
Correction : Sans traitement, les groupes auraient suivi des tendances parallèles.
Correction : Pas nécessairement. Importance statistique et importance économique sont distinctes.
1. Situation.
Prenez une réforme réelle et écrivez trois contrefactuels possibles. Pour chacun, expliquez ce qui le rend crédible ou fragile avant de choisir une méthode statistique.
Dessinez ensuite les données pré-traitement de deux groupes. Si leurs tendances divergent déjà avant la réforme, notez pourquoi une différence-de-différences simple serait suspecte.
2. Calcul guidé.
On compare un groupe traité et un groupe témoin avant et après une mesure. Le résultat moyen du groupe traité passe de 60 à 72 (+12), celui du témoin de 62 à 66 (+4). La différence de différences vaut 12 − 4 = 8 points. Cette estimation n’est causale que si l’hypothèse de tendances parallèles est défendable et si aucun choc spécifique ne perturbe un groupe.
3. Exercice autonome.
Dans un second exemple, le groupe traité passe de 70 à 84 et le groupe témoin de 68 à 76. Calculez la différence de différences puis indiquez l’hypothèse principale qu’il faut discuter.
Le traité progresse de 14 points et le témoin de 8 points. La différence de différences vaut donc 14 − 8 = 6 points. Ce nombre ne devient une estimation causale qu’après discussion des tendances parallèles, des changements de composition et des autres événements susceptibles d’affecter différemment les groupes.
Mini-évaluation spécifique.
On observe que les villes avec plus de pompiers ont davantage d’incendies. Pourquoi cette corrélation ne prouve-t-elle pas que les pompiers causent les incendies ?
La taille et la gravité des incendies expliquent à la fois le nombre de pompiers mobilisés et les dégâts. Il faut contrôler les variables confondantes et identifier un mécanisme causal.
8. Court terme, long terme et effets de second tour.
À court terme, certaines politiques produisent des effets visibles mais transitoires. À moyen terme, les comportements s’adaptent. À long terme, les unités peuvent quitter ou entrer dans l’échantillon, ce qui complique le suivi.
Dans « 8. Court terme, long terme et effets de second tour », la première question est celle de la preuve qui ferait abandonner l’identification retenue. Distinguez les effets indirects de l’impact immédiat. une politique dans une région peut influencer la région témoin via mobilité, commerce ou imitation. Terminez en séparant clairement estimation, incertitude, validité interne et portée externe.
9. Mini-dossier à refaire sans regarder la correction.
Mini-dossier : zone traitée chômage 9 % avant, 7 % après ; zone témoin 8 % avant, 7,5 % après. Calculez la DiD. Puis indiquez une hypothèse qu’il faut vérifier.
Correction : traité −2 points ; témoin −0,5 ; effet DiD −1,5 point. Il faut notamment vérifier que les tendances auraient été comparables sans traitement et qu’aucun choc spécifique n’a touché une seule zone.
Les méthodes causales répondent souvent à un effet moyen local : sur les unités affectées par l’instrument ou proches du seuil. Cette précision est une force, mais limite la généralisation.
La qualité des données — définitions, changements de codage, valeurs manquantes — peut créer des ruptures artificielles. Avant toute régression, il faut auditer la production de la donnée.
Enfin, l’évaluation utile doit relier estimation et décision. Un effet causal positif peut être trop coûteux ; un effet moyen nul peut cacher un sous-groupe très bénéficiaire. L’économétrie éclaire l’arbitrage, elle ne le remplace pas.
Deux variables augmentent ensemble sur dix années. Données pédagogiques : X passe de 100 à 140 et Y de 50 à 70. La corrélation décrit une coévolution ; elle ne prouve pas que X cause Y. Identifiez au moins trois variables confondantes possibles et proposez une expérience naturelle, une ou un protocole de comparaison permettant de renforcer l’identification causale.
Statut des nombres du cours 48 : exemples de calcul construits pour « Causalité, économétrie et lecture des données », à ne pas confondre avec une statistique officielle ni une prévision nationale.
Ce dernier livre-cours transforme la lecture de données en méthode de preuve. Une corrélation décrit une association; une prédiction cherche à anticiper une valeur; une question causale demande ce qui changerait sous une intervention. Un très prédictif peut être impropre à une décision causale s'il exploite des variables qui sont conséquences du traitement ou simples marqueurs.
Lecture : On compare le résultat sous traitement au résultat qui aurait été observé sans traitement pour une population comparable.
Source de méthode/formule : contraste de type différence-de-différences simplifié ; l'interprétation causale dépend des hypothèses d'identification.
Source de données/contexte : Insee — Inférence causale et évaluation d’impact.
Données : Après politique : traité +6, témoin +2. Effet simplifié ?
Formule : effet causal = E[Y|traitement, contrefactuel comparable] − E[Y|absence de traitement, contrefactuel comparable]
Substitution : 6 − 2
Calcul : Le groupe traité progresse de 6 unités tandis que le groupe témoin comparable progresse de 2. La différence des évolutions est donc 6 − 2 = 4.
Unité et résultat : environ 4 unités de l'indicateur étudié
Interprétation : Dans cette lecture simplifiée de différence de différences, 4 est attribuable au traitement seulement si les groupes sont comparables et si l'hypothèse de tendances parallèles est crédible.
Piège à éviter : Confondre corrélation observée et causalité sans stratégie d'identification.
Pour décider sur « Causalité, économétrie et lecture des données », publiez référence et hypothèses : doit pouvoir être corrigée par une preuve contraire: il faut donc écrire la question avant le modèle; dans une réforme publique, le scénario central et une variante sont comparés sur incertitude, pré-tendances et hétérogénéité, avec un calendrier explicite de réexamen.
Pour clore « Causalité, économétrie et lecture des données », gardez une chaîne de vérification : le lecteur doit retrouver incertitude, reconstruire pré-tendances, contrôler hétérogénéité et enfin choisir une identification adaptée; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
L’économétrie cherche à distinguer variation conjointe et effet causal. Une estimation utile commence par une question précise, une variable de résultat et un mécanisme plausible, puis décrit ce qui aurait dû se produire en l’absence du traitement. Les coefficients ne dispensent pas d’examiner qualité des données, sélection, spécification et incertitude. La causalité est une conclusion argumentée, pas une propriété automatique d’une régression.
Pour lire « Causalité, économétrie et lecture des données », séparez niveau, variation et mécanisme : reste cohérente seulement si les deux propriétés propres à cette section sont compatibles avec les données: une corrélation décrit une association; une prédiction cherche à anticiper une valeur; une question causale demande ce qui changerait sous une intervention; en même temps, un modèle très prédictif peut être impropre à une décision causale s'il exploite des variables qui sont conséquences du traitement ou simples marqueurs; le rapprochement d’incertitude, pré-tendances et hétérogénéité sert précisément à vérifier que l’explication tient dans ces deux dimensions.
Pour finaliser « Causalité, économétrie et lecture des données », confrontez résultat et limites : consiste à déplacer volontairement une hypothèse dans une réforme publique: incertitude reste constant, pré-tendances change et hétérogénéité indique si le diagnostic subsiste; cette expérience de sensibilité est complétée par l’obligation de choisir une identification adaptée et de conserver les cas qui contredisent le scénario préféré.
Deux variables peuvent évoluer ensemble sans que l’une cause l’autre ; prédire correctement un résultat n’implique pas non plus d’avoir identifié l’effet d’une intervention. Une corrélation décrit une association; une prédiction cherche à anticiper une valeur; une question causale demande ce qui changerait sous une intervention. Un modèle très prédictif peut être impropre à une décision causale s'il exploite des variables qui sont conséquences du traitement ou simples marqueurs.
Pour contrôler « Corrélation, prédiction et causalité », vérifiez d’abord unités et ordres de grandeur : relie tests de robustesse à effet estimé avant d’utiliser taille d'échantillon comme test de cohérence; une valeur centrale est accompagnée d’une distribution ou d’une fourchette dès que l’hétérogénéité de tests de robustesse change l’interprétation d’effet estimé.
Pour « Corrélation, prédiction et causalité », comparez les options sous des conditions explicites : il faut écrire la question avant le modèle; appliquée à une réforme publique, la méthode sépare le coût ou résultat mesuré par tests de robustesse, l’adaptation visible dans effet estimé et le contrôle fourni par taille d'échantillon, sans compter deux fois le même effet.
L’audit de « Corrélation, prédiction et causalité » exige qu’un tiers retrouve la source de tests de robustesse, le millésime d’effet estimé et la méthode appliquée à taille d'échantillon, puis qu’il puisse choisir une identification adaptée; une explication concurrente qui résiste à ce contrôle maintient la conclusion au rang d’hypothèse.
Corrélation, prédiction et causalité répondent à trois objectifs différents. Une variable peut être excellente pour prédire un résultat sans être un levier qui le provoque ; inversement un effet causal faible peut être important pour une politique ciblée. Avant d’intervenir sur une variable corrélée, il faut demander si la modifier changerait réellement le résultat ou seulement la relation statistique observée.
Dans « Corrélation, prédiction et causalité », écrivez le contrefactuel avant de regarder le coefficient. une corrélation décrit une association; une prédiction cherche à anticiper une valeur; une question causale demande ce qui changerait sous une intervention; un modèle très prédictif peut être impropre à une décision causale s'il exploite des variables qui sont conséquences du traitement ou simples marqueurs. Si tests de robustesse, effet estimé et taille d'échantillon donnent un tableau discordant, contrôlez l’identification, la qualité de mesure, la composition de l’échantillon et la spécification avant de parler d’effet causal.
L’effet causal d’un traitement est la différence entre ce qui arrive avec le traitement et ce qui serait arrivé à la même unité sans le traitement, état impossible à observer simultanément. Le contrefactuel est l'issue qui aurait été observée pour la même unité dans l'autre état de traitement; il est fondamentalement non observable au même moment. Toute stratégie causale construit donc une approximation crédible de ce scénario absent.
Pour mesurer « Le contrefactuel », croisez plusieurs indicateurs : taille d'échantillon, tests de robustesse et validité externe: taille d'échantillon donne l’ordre de grandeur, tests de robustesse renseignent la dynamique et validité externe sert de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour décider sur « Le contrefactuel », publiez référence et hypothèses : doit pouvoir être corrigée par une preuve contraire: il faut donc choisir une identification adaptée; dans une aide ciblée, le scénario central et une variante sont comparés sur taille d'échantillon, tests de robustesse et validité externe, avec un calendrier explicite de réexamen.
Pour reproduire « Le contrefactuel », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer taille d'échantillon, vérifier tests de robustesse et expliquer le rôle de validité externe; il doit aussi séparer observation et hypothèse, les limites non résolues restant datées et associées au résultat concerné.
Le contrefactuel est le résultat qui aurait été observé pour les mêmes unités sans l’intervention, résultat qui n’est jamais directement visible au même moment. Toute méthode causale tente donc de le reconstruire par comparaison : groupe témoin, discontinuité, tendance parallèle ou autre source de variation. La crédibilité dépend davantage de cette comparaison que de la sophistication mathématique de la formule finale.
Pour « Le contrefactuel », suivez les interactions du système : combine deux contraintes de la section: le contrefactuel est l'issue qui aurait été observée pour la même unité dans l'autre état de traitement; il est fondamentalement non observable au même moment, tandis que toute stratégie causale construit donc une approximation crédible de ce scénario absent; cette combinaison explique pourquoi taille d'échantillon, tests de robustesse et validité externe sont conservés ensemble même lorsqu’un seul indicateur suffirait à produire un graphique plus simple.
Pour « Le contrefactuel », explicitez le contrefactuel retenu : est enfin explicité dans une aide ciblée: une version conserve taille d'échantillon au niveau de référence, une autre fait varier tests de robustesse, puis validité externe mesure l’écart compatible avec le mécanisme; l’équipe doit séparer observation et hypothèse avant de retenir l’effet comme conséquence plausible plutôt que comme simple succession temporelle.
Biais de sélection.
Les bénéficiaires d’un programme peuvent différer des non-bénéficiaires avant même l’intervention ; comparer directement les deux groupes mélange alors effet du programme et différences initiales. Le biais de sélection apparaît lorsque les unités traitées diffèrent des autres pour des raisons liées au résultat potentiel. Comparer directement participants et non-participants attribue alors au traitement des différences qui existaient déjà.
Pour documenter « Biais de sélection », archivez données et transformations : qualité de mesure, hétérogénéité et effet estimé avec unités, sources et transformations; il cherche ensuite à écrire la question avant le modèle, et une contradiction entre sources est d’abord testée comme un écart de périmètre ou de millésime.
La randomisation rend, en moyenne, traitement et contrôle comparables avant l’intervention, ce qui permet d’attribuer les différences ultérieures au traitement sous réserve de conformité au protocole. L'assignation aléatoire rend, en moyenne, les groupes comparables avant traitement et fournit une base forte pour l'inférence causale. Non-respect de l'assignation, attrition ou contamination peuvent néanmoins fragiliser l'estimation et doivent être documentés.
L’audit de « Expérience aléatoire contrôlée » exige qu’un tiers retrouve la source d’incertitude, le millésime de pré-tendances et la méthode appliquée à hétérogénéité, puis qu’il puisse écrire la question avant le modèle; une explication concurrente qui résiste à ce contrôle maintient la conclusion au rang d’hypothèse.
Dans « Expérience aléatoire contrôlée », écrivez le contrefactuel avant de regarder le coefficient. l'assignation aléatoire rend, en moyenne, les groupes comparables avant traitement et fournit une base forte pour l'inférence causale; non-respect de l'assignation, attrition ou contamination peuvent néanmoins fragiliser l'estimation et doivent être documentés. Si incertitude, pré-tendances et hétérogénéité donnent un tableau discordant, contrôlez l’identification, la qualité de mesure, la composition de l’échantillon et la spécification avant de parler d’effet causal.
Intention de traiter et traitement réellement reçu — L’effet d’être assigné à un programme diffère de l’effet sur les personnes qui l’utilisent effectivement lorsque certains refusent ou accèdent au traitement hors groupe assigné. L'intention de traiter compare les groupes selon l'assignation initiale, même si certains ne suivent pas le traitement prévu. L'effet du traitement effectivement reçu répond à une autre question et demande des hypothèses supplémentaires lorsque l'adhésion n'est pas aléatoire.
Pour arbitrer « Intention de traiter et traitement réellement reçu », comparez coût, effets et réversibilité : séparer observation et hypothèse; appliqué à un programme expérimental, il compare validité externe et taille d'échantillon dans une situation inchangée puis dans une variante, tandis que les pré-tendances vérifie que le bénéfice apparent n’est pas obtenu par transfert du coût vers un autre acteur ou une autre période.
L’audit de « Intention de traiter et traitement réellement reçu » exige qu’un tiers retrouve la source de validité externe, le millésime de taille d'échantillon et la méthode appliquée à pré-tendances, puis qu’il puisse tester robustesse et validité externe; une explication concurrente qui résiste à ce contrôle maintient la conclusion au rang d’hypothèse.
La méthode compare l’évolution du groupe traité à celle d’un groupe témoin ; sa crédibilité dépend notamment de l’hypothèse de tendances parallèles sans traitement. La différence de différences soustrait l'évolution du groupe de comparaison à celle du groupe traité. Sa crédibilité repose notamment sur l'idée que, sans traitement, les trajectoires auraient évolué de façon comparable; les pré-tendances aident à examiner cette hypothèse.
Pour clore « Différences de différences », gardez une chaîne de vérification : le lecteur doit retrouver validité externe, reconstruire taille d'échantillon, contrôler pré-tendances et enfin écrire la question avant le modèle; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
La méthode des différences de différences compare l’évolution d’un groupe traité à celle d’un groupe non traité. Son hypothèse décisive est que, sans traitement, leurs trajectoires auraient évolué de façon suffisamment parallèle. Il faut donc regarder les tendances avant la réforme, les traitements simultanés et les changements de composition. Un graphique des périodes préalables est souvent plus instructif qu’un coefficient isolé.
Pour expertiser « Différences de différences », séparez le constat mesuré de l’interprétation économique. la différence de différences soustrait l'évolution du groupe de comparaison à celle du groupe traité. Reliez le résultat au contrefactuel, à l’identification, à l’incertitude et à la validité externe.
Étude d’événement.
Les coefficients estimés avant et après une réforme permettent d’observer la dynamique de l’effet et de tester si des tendances divergentes existaient déjà avant l’intervention. Une étude d'événement représente les effets estimés autour d'une date de traitement et permet de visualiser dynamique, anticipation et persistance. La spécification doit être adaptée lorsque les traitements commencent à des dates différentes pour éviter des comparaisons contaminées.
Pour mesurer « Étude d’événement », croisez plusieurs indicateurs : incertitude, pré-tendances et hétérogénéité: incertitude donne l’ordre de grandeur, pré-tendances renseignent la dynamique et hétérogénéité sert de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour « Étude d’événement », comparez les options sous des conditions explicites : il faut écrire la question avant le modèle; appliquée à une réforme publique, la méthode sépare le coût ou résultat mesuré par incertitude, l’adaptation visible dans pré-tendances et le contrôle fourni par hétérogénéité, sans compter deux fois le même effet.
Pour clore « Étude d’événement », gardez une chaîne de vérification : le lecteur doit retrouver incertitude, reconstruire pré-tendances, contrôler hétérogénéité et enfin choisir une identification adaptée; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
Lorsqu’une règle attribue le traitement de part et d’autre d’un seuil, les unités proches peuvent être comparées si elles ne manipulent pas précisément leur position autour du seuil. Une régression sur discontinuité exploite une règle de seuil: des unités très proches de part et d'autre peuvent être comparables sauf pour la probabilité de traitement. La validité est locale autour du seuil et suppose notamment l'absence de manipulation précise de la variable d'affectation.
Pour arbitrer « Régression sur discontinuité », comparez coût, effets et réversibilité : écrire la question avant le modèle; appliqué à un programme expérimental, il compare taille d'échantillon et tests de robustesse dans une situation inchangée puis dans une variante, tandis que la validité externe vérifie que le bénéfice apparent n’est pas obtenu par transfert du coût vers un autre acteur ou une autre période.
Un instrument doit modifier la probabilité de traitement sans affecter directement le résultat par une autre voie ; cette condition d’exclusion est forte et doit être argumentée. Une variable instrumentale déplace le traitement sans affecter directement le résultat par un autre canal pertinent. La force de l'instrument et l'exclusion du canal direct sont des questions distinctes; un instrument faible peut produire des estimations très instables.
Pour mesurer « Variables instrumentales », croisez plusieurs indicateurs : tests de robustesse, effet estimé et taille d'échantillon: tests de robustesse donnent l’ordre de grandeur, effet estimé renseigne la dynamique et taille d'échantillon sert de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour « Variables instrumentales », comparez les options sous des conditions explicites : il faut choisir une identification adaptée; appliquée à un programme expérimental, la méthode sépare le coût ou résultat mesuré par tests de robustesse, l’adaptation visible dans effet estimé et le contrôle fourni par taille d'échantillon, sans compter deux fois le même effet.
Pour rendre « Variables instrumentales » reproductible, les pièces publiées doivent suffire à reconstruire tests de robustesse, retrouver effet estimé et comprendre taille d'échantillon; l’auditeur doit ensuite séparer observation et hypothèse, et toute variante qui change le résultat est conservée près de la conclusion qu’elle fragilise.
et score de propension — L’ cherche à comparer des unités similaires sur les caractéristiques observées, mais il ne corrige pas automatiquement les facteurs non observés qui influencent traitement et résultat. Les données administratives offrent souvent couverture et précision utiles, mais leur finalité de gestion peut créer changements de définition et variables absentes pour la recherche. L'appariement entre bases doit mesurer les non-appariements et protéger la confidentialité.
Pour mesurer « Appariement et score de propension », croisez plusieurs indicateurs : effet estimé, qualité de mesure et tests de robustesse: effet estimé donne l’ordre de grandeur, qualité de mesure renseigne la dynamique et tests de robustesse servent de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour reproduire « Appariement et score de propension », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer effet estimé, vérifier qualité de mesure et expliquer le rôle de tests de robustesse; il doit aussi choisir une identification adaptée, les limites non résolues restant datées et associées au résultat concerné.
Régression multivariée et variables de contrôle.
Ajouter des contrôles peut réduire certains biais, mais contrôler une variable causée par le traitement ou un mauvais intermédiaire peut au contraire créer un biais. Une régression conditionnelle mesure une association après ajustement pour les variables incluses; son interprétation causale dépend du choix des contrôles. Contrôler une variable causée par le traitement peut introduire un biais plutôt que le réduire.
L’audit de « Régression multivariée et variables de contrôle » exige qu’un tiers retrouve la source de pré-tendances, le millésime de validité externe et la méthode appliquée à incertitude, puis qu’il puisse séparer observation et hypothèse; une explication concurrente qui résiste à ce contrôle maintient la conclusion au rang d’hypothèse.
Un graphe orienté aide à formaliser les relations supposées entre variables et à distinguer confondeur, médiateur, collisionneur et résultat. Un graphe causal explicite les relations supposées entre variables et aide à distinguer confondeur, médiateur, collidant et conséquence. Son intérêt principal est de rendre discutables des hypothèses qui resteraient sinon cachées dans une liste de variables de contrôle.
Pour reproduire « Graphes causaux et variables confondantes », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer hétérogénéité, vérifier incertitude et expliquer le rôle de qualité de mesure; il doit aussi choisir une identification adaptée, les limites non résolues restant datées et associées au résultat concerné.
Pour lire « Graphes causaux et variables confondantes », séparez niveau, variation et mécanisme : reste cohérente seulement si les deux propriétés propres à cette section sont compatibles avec les données: un graphe causal explicite les relations supposées entre variables et aide à distinguer confondeur, médiateur, collidant et conséquence; en même temps, son intérêt principal est de rendre discutables des hypothèses qui resteraient sinon cachées dans une liste de variables de contrôle; le rapprochement d’hétérogénéité, incertitude et qualité de mesure sert précisément à vérifier que l’explication tient dans ces deux dimensions.
Biais de variable omise.
Si une variable non observée influence à la fois l’explication et le résultat, le coefficient estimé peut attribuer à tort son effet à la variable étudiée. Une variable omise biaise un coefficient si elle influence le résultat et est corrélée avec la variable explicative d'intérêt. Ajouter beaucoup de contrôles au hasard n'est pas une solution; il faut comprendre la structure causale et la qualité des mesures.
Pour reproduire « Biais de variable omise », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer incertitude, vérifier pré-tendances et expliquer le rôle d’hétérogénéité; il doit aussi tester robustesse et validité externe, les limites non résolues restant datées et associées au résultat concerné.
Une variable omise crée un biais lorsqu’elle influence le résultat et est corrélée avec l’explication étudiée. Ajouter de nombreux contrôles ne garantit pas la causalité : certains peuvent être mal mesurés, postérieurs au traitement ou eux-mêmes causés par celui-ci. Le raisonnement doit identifier le facteur manquant plausible, prévoir le sens du biais et chercher une stratégie de comparaison moins dépendante de ce facteur.
Erreur de mesure — Une variable mal mesurée peut atténuer ou déformer une relation ; la nature du biais dépend de la variable concernée et du mécanisme de l’erreur. Une mesure bruitée peut atténuer ou déplacer des coefficients, tandis qu'une erreur systématique peut créer des biais plus complexes. La provenance, l'unité, la fréquence de collecte et les changements de définition font partie intégrante de l'analyse économétrique.
Pour arbitrer « Erreur de mesure », comparez coût, effets et réversibilité : tester robustesse et validité externe; appliqué à un changement de règle, il compare validité externe et taille d'échantillon dans une situation inchangée puis dans une variante, tandis que les pré-tendances vérifie que le bénéfice apparent n’est pas obtenu par transfert du coût vers un autre acteur ou une autre période.
Pour documenter « Erreur de mesure », archivez données et transformations : validité externe, taille d'échantillon et pré-tendances avec unités, sources et transformations; il cherche ensuite à écrire la question avant le modèle, et une contradiction entre sources est d’abord testée comme un écart de périmètre ou de millésime.
L’erreur de mesure peut atténuer, amplifier ou déplacer une relation estimée selon qu’elle touche la variable expliquée, l’explicative et selon sa structure. Les données administratives ne sont pas exemptes d’erreurs : elles reflètent des règles de gestion et des changements de définition. Il faut documenter source, fréquence, révisions et ruptures de série, puis tester si le résultat subsiste avec une mesure alternative.
Taille d’échantillon et puissance statistique.
Un petit échantillon peut manquer un effet réel ; un échantillon immense peut rendre statistiquement significatif un effet économiquement minuscule. La puissance est la probabilité de détecter un effet d'une taille donnée avec un protocole donné; elle dépend de , taille d'échantillon et plan expérimental. Une étude sous-dimensionnée peut produire des estimations très incertaines même si la méthode d'identification est correcte.
Pour « Taille d’échantillon et puissance statistique », tests de robustesse n’est jamais interprété seul: il est rapproché d’effet estimé sur la même période et testé avec taille d'échantillon; si ces mesures racontent des histoires différentes, la divergence est documentée au lieu de sélectionner silencieusement l’indicateur le plus favorable.
Pour documenter « Taille d’échantillon et puissance statistique », archivez données et transformations : tests de robustesse, effet estimé et taille d'échantillon avec unités, sources et transformations; il cherche ensuite à séparer observation et hypothèse, et une contradiction entre sources est d’abord testée comme un écart de périmètre ou de millésime.
Pour « Taille d’échantillon et puissance statistique », regardez aussi la distribution : tests de robustesse ne cache pas des trajectoires opposées d’effet estimé; la taille d'échantillon sert à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
L’intervalle résume l’incertitude d’estimation sous les hypothèses du modèle et rappelle qu’un coefficient estimé n’est pas la valeur vraie connue avec certitude. Un intervalle de confiance exprime l'incertitude d'estimation sous les hypothèses du modèle et de l'échantillonnage. Sa largeur importe autant que le signe du point estimé lorsque la décision dépend d'une taille d'effet économiquement pertinente.
Pour contrôler « Intervalle de confiance », vérifiez d’abord unités et ordres de grandeur : relie incertitude à pré-tendances avant d’utiliser hétérogénéité comme test de cohérence; une valeur centrale est accompagnée d’une distribution ou d’une fourchette dès que l’hétérogénéité d’incertitude change l’interprétation de pré-tendances.
Pour reproduire « Intervalle de confiance », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer incertitude, vérifier pré-tendances et expliquer le rôle d’hétérogénéité; il doit aussi tester robustesse et validité externe, les limites non résolues restant datées et associées au résultat concerné.
Pour « Intervalle de confiance », regardez aussi la distribution : incertitude ne cache pas des trajectoires opposées de pré-tendances; l’hétérogénéité sert à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
Pour vérifier « Intervalle de confiance », reliez incitations et contraintes : s’évalue à partir de deux repères spécifiques: un intervalle de confiance exprime l'incertitude d'estimation sous les hypothèses du modèle et de l'échantillonnage; et sa largeur importe autant que le signe du point estimé lorsque la décision dépend d'une taille d'effet économiquement pertinente; le rôle d’incertitude, pré-tendances et hétérogénéité est de transformer ces repères en vérifications séparées, afin qu’un seul bon chiffre ne suffise jamais à valider tout le mécanisme.
La valeur p ne mesure ni la probabilité que l’hypothèse soit vraie ni l’importance de l’effet ; multiplier les tests augmente la probabilité de résultats significatifs par hasard. Une valeur p n'est ni la probabilité que l'hypothèse nulle soit vraie ni la taille de l'effet. Multiplier les tests augmente les découvertes fortuites; pré-spécification, corrections et transparence sur l'ensemble des tests limitent ce risque.
Pour décider sur « Valeur p et tests multiples », publiez référence et hypothèses : doit pouvoir être corrigée par une preuve contraire: il faut donc séparer observation et hypothèse; dans une réforme publique, le scénario central et une variante sont comparés sur hétérogénéité, incertitude et qualité de mesure, avec un calendrier explicite de réexamen.
Pour tester « Valeur p et tests multiples », cherchez d’abord les contradictions internes : confronte directement le mécanisme aux mesures: une valeur p n'est ni la probabilité que l'hypothèse nulle soit vraie ni la taille de l'effet, donc hétérogénéité ne peut être interprété sans incertitude; multiplier les tests augmente les découvertes fortuites; pré-spécification, corrections et transparence sur l'ensemble des tests limitent ce risque, donc qualité de mesure doit être vérifié avant de conclure à un effet net dans une chaîne reliant question, données, contrefactuel et identification.
Effets hétérogènes.
Un programme peut être utile en moyenne et inefficace ou nuisible pour certains groupes ; l’hétérogénéité doit être étudiée sans transformer chaque sous-groupe en test opportuniste. Un effet moyen peut masquer des effets différents selon âge, territoire, niveau initial ou contexte. Explorer l'hétérogénéité doit rester discipliné pour éviter de sélectionner après coup le sous-groupe qui donne le résultat souhaité.
Pour contrôler « Effets hétérogènes », vérifiez d’abord unités et ordres de grandeur : relie pré-tendances à validité externe avant d’utiliser incertitude comme test de cohérence; une valeur centrale est accompagnée d’une distribution ou d’une fourchette dès que l’hétérogénéité de pré-tendances change l’interprétation de validité externe.
Pour documenter « Effets hétérogènes », archivez données et transformations : pré-tendances, validité externe et incertitude avec unités, sources et transformations; il cherche ensuite à tester robustesse et validité externe, et une contradiction entre sources est d’abord testée comme un écart de périmètre ou de millésime.
Validité interne et validité externe.
Une étude peut identifier proprement un effet dans son échantillon mais ne pas être transposable à une autre population, période ou institution. La validité interne concerne la crédibilité causale dans l'étude; la validité externe concerne la transposition à d'autres populations, lieux ou périodes. Améliorer l'une ne garantit pas automatiquement l'autre.
Pour mesurer « Validité interne et validité externe », croisez plusieurs indicateurs : effet estimé, qualité de mesure et tests de robustesse: effet estimé donne l’ordre de grandeur, qualité de mesure renseigne la dynamique et tests de robustesse servent de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour clore « Validité interne et validité externe », gardez une chaîne de vérification : le lecteur doit retrouver effet estimé, reconstruire qualité de mesure, contrôler tests de robustesse et enfin écrire la question avant le modèle; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
Pour « Validité interne et validité externe », regardez aussi la distribution : effet estimé ne cache pas des trajectoires opposées de qualité de mesure; les tests de robustesse servent à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
Spillovers et interférences — Le traitement d’une unité peut affecter les autres, par exemple via prix, imitation ou réseau ; l’hypothèse d’indépendance entre unités doit alors être adaptée. Un spillover apparaît lorsque le traitement d'une unité affecte le résultat d'une autre; l'hypothèse d'indépendance entre unités devient alors fausse. Il faut parfois randomiser par groupe ou mesurer explicitement l'exposition au traitement des voisins.
Pour mesurer « Spillovers et interférences », croisez plusieurs indicateurs : validité externe, taille d'échantillon et pré-tendances: validité externe donne l’ordre de grandeur, taille d'échantillon renseigne la dynamique et pré-tendances servent de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour clore « Spillovers et interférences », gardez une chaîne de vérification : le lecteur doit retrouver validité externe, reconstruire taille d'échantillon, contrôler pré-tendances et enfin écrire la question avant le modèle; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
Pour vérifier « Spillovers et interférences », reliez incitations et contraintes : s’évalue à partir de deux repères spécifiques: un spillover apparaît lorsque le traitement d'une unité affecte le résultat d'une autre; l'hypothèse d'indépendance entre unités devient alors fausse; et il faut parfois randomiser par groupe ou mesurer explicitement l'exposition au traitement des voisins; le rôle de validité externe, taille d'échantillon et pré-tendances est de transformer ces repères en vérifications séparées, afin qu’un seul bon chiffre ne suffise jamais à valider tout le mécanisme.
Observer les mêmes unités dans le temps permet de contrôler certaines caractéristiques invariables, sans éliminer pour autant tous les biais liés aux chocs simultanés. Les données de panel suivent les mêmes unités dans le temps; les effets fixes absorbent certaines caractéristiques invariantes de chaque unité. Ils ne corrigent pas les confondeurs qui évoluent dans le temps et restent corrélés avec le traitement.
Pour analyser « Données de panel et effets fixes », séparez les mécanismes possibles : hétérogénéité fournit le repère principal mais incertitude permet d’identifier une réponse des acteurs et qualité de mesure un éventuel ; le résultat est publié avec la période et le périmètre nécessaires à sa reproduction.
Pour rendre « Données de panel et effets fixes » reproductible, les pièces publiées doivent suffire à reconstruire hétérogénéité, retrouver incertitude et comprendre qualité de mesure; l’auditeur doit ensuite choisir une identification adaptée, et toute variante qui change le résultat est conservée près de la conclusion qu’elle fragilise.
Dans « Données de panel et effets fixes », la première question est celle de la preuve qui ferait abandonner l’identification retenue. les données de panel suivent les mêmes unités dans le temps; les effets fixes absorbent certaines caractéristiques invariantes de chaque unité. Terminez en séparant clairement estimation, incertitude, validité interne et portée externe.
Séries temporelles et ruptures.
Tendance, saisonnalité, autocorrélation et changements de régime compliquent l’identification d’un effet lorsque le traitement intervient à une date unique. Une série temporelle possède tendance, saisonnalité et dépendance temporelle; une rupture observée après une politique n'est pas automatiquement causée par elle. L'analyse doit examiner autres événements simultanés et stabilité du processus avant la rupture.
Pour « Séries temporelles et ruptures », le diagnostic utile part du mécanisme observable plutôt que d’une formule générale. une série temporelle possède tendance, saisonnalité et dépendance temporelle; une rupture observée après une politique n'est pas automatiquement causée par elle. Reliez le résultat au contrefactuel, à l’identification, à l’incertitude et à la validité externe.
Économétrie spatiale — Les observations proches peuvent être interdépendantes ; ignorer l’autocorrélation ou les débordements spatiaux peut conduire à des erreurs d’inférence. Les observations proches géographiquement peuvent partager chocs et comportements; ignorer cette dépendance rend parfois l'incertitude trop optimiste. Les frontières administratives et effets de voisinage doivent être compatibles avec la question étudiée.
Pour mesurer « Économétrie spatiale », croisez plusieurs indicateurs : hétérogénéité, incertitude et qualité de mesure: hétérogénéité donne l’ordre de grandeur, incertitude renseigne la dynamique et qualité de mesure sert de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour rendre « Économétrie spatiale » reproductible, les pièces publiées doivent suffire à reconstruire hétérogénéité, retrouver incertitude et comprendre qualité de mesure; l’auditeur doit ensuite choisir une identification adaptée, et toute variante qui change le résultat est conservée près de la conclusion qu’elle fragilise.
Dans « Économétrie spatiale », la première question est celle de la preuve qui ferait abandonner l’identification retenue. les observations proches géographiquement peuvent partager chocs et comportements; ignorer cette dépendance rend parfois l'incertitude trop optimiste. Terminez en séparant clairement estimation, incertitude, validité interne et portée externe.
Le cas d’un programme expérimental sert aussi à tester la transférabilité de « Économétrie spatiale »: après comparaison d’hétérogénéité, incertitude et qualité de mesure, le rapport vérifie si le même mécanisme resterait plausible avec une population, une période ou une capacité différente; il doit choisir une identification adaptée avant toute généralisation.
Un modèle prédictif peut exploiter des centaines de variables et rester incapable de dire ce qui se passerait si une politique changeait une de ces variables. Le machine learning excelle à capter des relations prédictives complexes, mais l'identification causale exige toujours une comparaison contrefactuelle crédible. Ces outils peuvent toutefois améliorer nuisance functions, ciblage ou hétérogénéité lorsqu'ils sont intégrés à un design causal explicite.
Pour objectiver « Machine learning : prédire n’est pas identifier », le dossier suit pré-tendances avec validité externe, puis confronte leur évolution à incertitude; le millésime, le champ et le dénominateur de pré-tendances restent visibles afin qu’une rupture statistique ne soit pas prise pour un changement économique.
Pour arbitrer « Machine learning : prédire n’est pas identifier », comparez coût, effets et réversibilité : tester robustesse et validité externe; appliqué à une réforme publique, il compare pré-tendances et validité externe dans une situation inchangée puis dans une variante, tandis que l’incertitude vérifie que le bénéfice apparent n’est pas obtenu par transfert du coût vers un autre acteur ou une autre période.
Données administratives et appariement — Les données administratives offrent souvent de grands effectifs et une bonne continuité, mais leur usage exige gouvernance, qualité, définition des champs et protection des personnes. Les données administratives offrent souvent couverture et précision utiles, mais leur finalité de gestion peut créer changements de définition et variables absentes pour la recherche. L'appariement entre bases doit mesurer les non-appariements et protéger la confidentialité.
Pour mesurer « Données administratives et appariement », croisez plusieurs indicateurs : taille d'échantillon, tests de robustesse et validité externe: taille d'échantillon donne l’ordre de grandeur, tests de robustesse renseignent la dynamique et validité externe sert de contrôle lorsque les deux premiers indicateurs divergent; les trois séries conservent unité, période et périmètre.
Pour rendre « Données administratives et appariement » reproductible, les pièces publiées doivent suffire à reconstruire taille d'échantillon, retrouver tests de robustesse et comprendre validité externe; l’auditeur doit ensuite écrire la question avant le modèle, et toute variante qui change le résultat est conservée près de la conclusion qu’elle fragilise.
L’appariement de données administratives offre une grande profondeur longitudinale mais crée des enjeux techniques et juridiques. Identifiants, doublons, changements de statut et taux d’appariement peuvent sélectionner les observations conservées. Avant toute estimation, il faut publier le taux de correspondance, décrire les enregistrements perdus et vérifier si les personnes non appariées diffèrent systématiquement des autres.
Dans « Données administratives et appariement », écrivez le contrefactuel avant de regarder le coefficient. les données administratives offrent souvent couverture et précision utiles, mais leur finalité de gestion peut créer changements de définition et variables absentes pour la recherche; l'appariement entre bases doit mesurer les non-appariements et protéger la confidentialité. Si taille d'échantillon, tests de robustesse et validité externe donnent un tableau discordant, contrôlez l’identification, la qualité de mesure, la composition de l’échantillon et la spécification avant de parler d’effet causal.
Pour finaliser « Données administratives et appariement », confrontez résultat et limites : consiste à déplacer volontairement une hypothèse dans un programme expérimental: taille d'échantillon reste constant, tests de robustesse change et validité externe indique si le diagnostic subsiste; cette expérience de sensibilité est complétée par l’obligation d’écrire la question avant le modèle et de conserver les cas qui contredisent le scénario préféré.
Reproductibilité, code et journal des transformations.
Une analyse crédible conserve le code, les paramètres, les versions de données et la succession des transformations afin qu’un tiers puisse retrouver le résultat. Une analyse reproductible conserve données d'entrée, versions, code, paramètres et ordre des transformations. Le journal de traitement permet de distinguer une correction légitime d'une sélection opportuniste après observation des résultats.
Pour objectiver « Reproductibilité, code et journal des transformations », le dossier suit incertitude avec pré-tendances, puis confronte leur évolution à hétérogénéité; le millésime, le champ et le dénominateur d’incertitude restent visibles afin qu’une rupture statistique ne soit pas prise pour un changement économique.
Pour clore « Reproductibilité, code et journal des transformations », gardez une chaîne de vérification : le lecteur doit retrouver incertitude, reconstruire pré-tendances, contrôler hétérogénéité et enfin tester robustesse et validité externe; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
Pour « Reproductibilité, code et journal des transformations », regardez aussi la distribution : incertitude ne cache pas des trajectoires opposées de pré-tendances; l’hétérogénéité sert à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
Axe tronqué, changement d’unité, sélection de période, cumul et base 100 peuvent modifier fortement la perception visuelle d’une même série. Un graphique peut tromper par axe tronqué, unité changeante, double échelle, sélection de période ou agrégation. La première lecture doit retrouver source, dénominateur, fréquence, périmètre et éventuelles ruptures de série avant d'interpréter la forme.
L’observation de « Lire un graphique sans se faire piéger » est construite autour d’hétérogénéité, incertitude et qualité de mesure; chaque transformation appliquée à hétérogénéité est conservée dans le dossier et toute différence de champ avec incertitude ou qualité de mesure est résolue avant de calculer une tendance.
Pour décider sur « Lire un graphique sans se faire piéger », publiez référence et hypothèses : doit pouvoir être corrigée par une preuve contraire: il faut donc tester robustesse et validité externe; dans un changement de règle, le scénario central et une variante sont comparés sur hétérogénéité, incertitude et qualité de mesure, avec un calendrier explicite de réexamen.
Pour clore « Lire un graphique sans se faire piéger », gardez une chaîne de vérification : le lecteur doit retrouver hétérogénéité, reconstruire incertitude, contrôler qualité de mesure et enfin écrire la question avant le modèle; une hypothèse qui ne peut pas être testée est signalée comme telle et n’est pas transformée en fait par la mise en page.
Un graphique peut orienter la perception par son échelle, son origine, son intervalle temporel ou la sélection des séries. La première vérification porte sur axes, unités, source et population ; la seconde sur ce qui manque. Une rupture visuelle impressionnante peut devenir modeste avec une échelle complète, tandis qu’une moyenne peut masquer des distributions divergentes. Refaire le graphique avec une autre échelle est un test simple et puissant.
Pour « Lire un graphique sans se faire piéger », le diagnostic utile part du mécanisme observable plutôt que d’une formule générale. un graphique peut tromper par axe tronqué, unité changeante, double échelle, sélection de période ou agrégation. Reliez le résultat au contrefactuel, à l’identification, à l’incertitude et à la validité externe.
Pour « Lire un graphique sans se faire piéger », explicitez le contrefactuel retenu : est enfin explicité dans un changement de règle: une version conserve hétérogénéité au niveau de référence, une autre fait varier incertitude, puis qualité de mesure mesure l’écart compatible avec le mécanisme; l’équipe doit écrire la question avant le modèle avant de retenir l’effet comme conséquence plausible plutôt que comme simple succession temporelle.
De l’étude à la décision publique — Une estimation causale n’épuise pas la décision : coûts, distribution, capacité d’exécution, acceptabilité et incertitude doivent encore être intégrés. Une estimation causale n'est qu'un de décision: coût, distribution, faisabilité, incertitude et effets non mesurés doivent aussi être considérés. La décision gagne à définir ce qui constituerait un effet suffisamment grand pour justifier l'action.
L’audit de « De l’étude à la décision publique » exige qu’un tiers retrouve la source de qualité de mesure, le millésime d’hétérogénéité et la méthode appliquée à effet estimé, puis qu’il puisse choisir une identification adaptée; une explication concurrente qui résiste à ce contrôle maintient la conclusion au rang d’hypothèse.
Pour « De l’étude à la décision publique », regardez aussi la distribution : qualité de mesure ne cache pas des trajectoires opposées d’hétérogénéité; l’effet estimé sert à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
Dans « De l’étude à la décision publique », la conclusion dépend d’un enchaînement précis entre indicateur, comportement et résultat. une estimation causale n'est qu'un intrant de décision: coût, distribution, faisabilité, incertitude et effets non mesurés doivent aussi être considérés. Reliez le résultat au contrefactuel, à l’identification, à l’incertitude et à la validité externe.
L’audit identifie la question causale, le traitement, le résultat, le contrefactuel, les hypothèses d’identification, les tests de robustesse et le champ auquel la conclusion peut réellement s’appliquer. Un audit économétrique écrit la question, le traitement, le résultat et le contrefactuel avant de choisir une stratégie d’identification. La robustesse ne consiste pas à multiplier les modèles jusqu’à obtenir un signe attendu : elle teste les hypothèses, l’incertitude, les pré-tendances et la validité externe de façon traçable.
L’observation de « étude économétrique » est construite autour d’effet estimé, qualité de mesure et tests de robustesse; chaque transformation appliquée à effet estimé est conservée dans le dossier et toute différence de champ avec qualité de mesure ou tests de robustesse est résolue avant de calculer une tendance.
Pour reproduire « étude économétrique », conservez les hypothèses et calculs : suppose qu’un contrôleur extérieur puisse recalculer effet estimé, vérifier qualité de mesure et expliquer le rôle de tests de robustesse; il doit aussi écrire la question avant le modèle, les limites non résolues restant datées et associées au résultat concerné.
Pour « étude économétrique », regardez aussi la distribution : effet estimé ne cache pas des trajectoires opposées de qualité de mesure; les tests de robustesse servent à localiser l’effet dans un groupe, un territoire ou une période avant toute généralisation.
Pour vérifier Causalité, économétrie et lecture des données, consignez définition et source de Causalité, économétrie et lecture des données, puis millésime, unité et champ de Causalité, économétrie et lecture des données. Pour Causalité, économétrie et lecture des données, la vérification autonome fixe d’abord le champ d’effet estimé et la période de qualité de mesure. Ce cadrage applique directement le principe suivant : Un audit économétrique écrit la question, le traitement, le résultat et le contrefactuel avant de choisir une stratégie d’identification.
Dans Causalité, économétrie et lecture des données, chaque valeur d’effet estimé conserve sa source et son millésime. Toute transformation vers tests de robustesse reste accompagnée des opérations nécessaires au recalcul par un tiers.
Dans « Méthode de vérification autonome », la première question est celle de la preuve qui ferait abandonner l’identification retenue. Gardez le scénario de référence comme comparaison, pas comme certitude. est écrit avant de lire qualité de mesure. Une évolution après une mesure n’est attribuée à cette mesure que si la méthode de comparaison répond à la question causale posée. Terminez en séparant clairement estimation, incertitude, validité interne et portée externe.
Pour tester Causalité, économétrie et lecture des données, une variante fait évoluer tests de robustesse et une hypothèse de comportement. Le rapport isole alors ce qui demeure stable et ce qui dépend de cette hypothèse, en tenant compte du constat suivant : La robustesse ne consiste pas à multiplier les modèles jusqu’à obtenir un signe attendu : elle teste les hypothèses, l’incertitude, les pré-tendances et la validité externe de façon traçable.
Un lecteur extérieur de Causalité, économétrie et lecture des données doit pouvoir retrouver effet estimé, refaire le calcul et remplacer une hypothèse. Si qualité de mesure change la conclusion, cette sensibilité est publiée au lieu d’être absorbée dans un chiffre central.
Les exercices passent du concept au calcul vérifiable. l’énoncé est d’abord traduit en validité externe et taille d'échantillon. Leur unité et leur période sont fixées avant le calcul, conformément à cette exigence : Un audit économétrique écrit la question, le traitement, le résultat et le contrefactuel avant de choisir une stratégie d’identification.
Pour Causalité, économétrie et lecture des données, le signe et l’ordre de grandeur du résultat sont confrontés à pré-tendances. Une valeur numériquement correcte est rejetée si elle contredit le mécanisme suivant sans explication : La robustesse ne consiste pas à multiplier les modèles jusqu’à obtenir un signe attendu : elle teste les hypothèses, l’incertitude, les pré-tendances et la validité externe de façon traçable.
En pratique, choisissez les données puis contrôlez les unités. mobilise enfin l'évaluation d'une réforme, d'une aide, d'un changement de règle ou d'un programme public et fait varier taille d'échantillon. Le résultat doit rester interprétable à la lumière de pré-tendances, sinon l’exercice explique pourquoi une autre méthode répond à une question différente.
Non. Il faut savoir ce qui se serait passé sans la zone : tendance générale, météo, travaux voisins, tourisme ou ouverture d’un commerce peuvent expliquer une partie de la hausse. Il faut construire un contrefactuel crédible.
Parce qu’il peut utiliser des variables corrélées au chômage sans savoir comment elles changeraient après une intervention. La prédiction décrit P(Y|X) ; la causalité cherche l’effet d’une action sur Y.
Non. La valeur p renseigne sur la compatibilité avec l’hypothèse nulle sous le modèle, pas sur l’importance économique. Il faut regarder taille d’effet, intervalle de confiance, coût et conséquences pratiques.
ÉCOLE D’ÉCONOMIE · FORMATION ACTIVE
Compétences visées. Construire un contrefactuel; discuter identification; tester robustesse et validité externe.
1. Situation concrète.
Vous maîtrisez déjà les notions principales de Causalité, économétrie et données. Cette étape transforme le cours en exercice de décision plus proche d’un dossier réel.
2. Exercice.
Un programme augmente l’emploi de 4 points dans les zones traitées, tandis que les zones témoins gagnent 1,5 point. Calculez une différence de différences simple et listez les hypothèses.
3. Calcul ou raisonnement attendu.
Estimation simple : 4 - 1,5 = 2,5 points. L’interprétation causale suppose notamment des tendances parallèles crédibles sans traitement, pas de choc différentiel majeur et une mesure comparable.
4. Pièges fréquents.
5. Auto-évaluation.
Critère de validation. Le livrable doit représenter traité, témoin et contrefactuel, écrire l'estimateur choisi, puis lister l'hypothèse dont la violation invaliderait l'interprétation causale ; une p-value seule ne constitue jamais la conclusion.
6. Livrable.
← Dossier précédent : Inégalités, pauvreté et mobilité sociale
Questions fréquentes.
L’objectif principal est de savoir construire un contrefactuel, puis d’expliquer les hypothèses et les limites du résultat.
Situation. Une région subventionne en priorité les entreprises dont l’emploi baissait déjà. Un an plus tard, l’emploi des bénéficiaires reste inférieur à celui des non-bénéficiaires.
Travail demandé. Définissez la question causale, choisissez un contrefactuel plausible et expliquez les données nécessaires. Proposez au moins deux méthodes et indiquez ce qui ferait échouer chacune.
La comparaison brute est biaisée car le traitement est attribué aux entreprises déjà fragiles. Un appariement sur trajectoires antérieures peut réduire le biais observable ; une règle d’éligibilité créant un seuil peut permettre une discontinuité. Sans hypothèse de comparabilité crédible, on ne peut pas transformer l’écart observé en effet du programme.
Déclarer la causalité parce qu'une régression est significative, choisir le groupe contrôle après avoir vu le résultat, ignorer les tendances avant traitement, confondre absence de preuve et preuve d'absence.
De la compréhension au diagnostic : Causalité et économétrie.
1. Relation à savoir reconstruire.
DiD = (T_après − T_avant) − (C_après − C_avant)Comparer « avant/après » sans groupe de contrôle confond souvent effet de la politique et tendance générale.
2. Le piège qui fausse le plus souvent le débat.
Une corrélation robuste n’est pas automatiquement causale : identifier mécanisme, sélection et variables confondantes.
3. Les données minimales à exiger.
4. Exercice de vérification.
Traitement : 50→70 ; contrôle : 40→50. Effet DiD ?
(70−50) − (50−40) = 20 − 10 = 10 unités.
5. Êtes-vous capable de contredire proprement une affirmation ?.
Ces deux ouvrages offrent un terrain d’application aux méthodes de preuve du cours : chiffrages budgétaires, consolidation des économies, hypothèses de transition et comparaison de trajectoires financières.

Le dossier fondateur : finances publiques, structures, calendrier et mesures.
Voir le livre et la lecture gratuite →