Module 0 — Mathématiques et statistiques utiles à l’économie
Ce module reconstruit les outils avant de les employer. Le but n’est pas d’apprendre des symboles par cœur mais de savoir les lire, les prononcer, les calculer, contrôler leurs unités et expliquer ce qu’un résultat permet de conclure. Les exercices sont volontairement progressifs : arithmétique, proportionnalité, algèbre, graphiques, croissance, statistiques, probabilités, régression puis inférence.
Diagnostic de départ et règle des unités
Si vous ne savez plus combien vaut 3 + 4 × 5, comment convertir 0,07 en , pourquoi +10 % puis −10 % ne s’annulent pas, ou ce que signifient Σ, Δ, α et ², vous êtes au bon endroit. Aucun de ces signes ne sera utilisé avant d’avoir été nommé.
Règle absolue : un nombre économique sans unité et sans période est incomplet. « 50 » peut signifier 50 €, 50 %, 50 personnes, 50 MWh ou 50 milliards d’euros par an. Avant toute opération, écrivez l’unité à côté de chaque donnée.
1. Les quatre opérations, les parenthèses et les priorités opératoires
Additionner signifie réunir des quantités compatibles. Soustraire signifie comparer ou retirer. Multiplier signifie répéter une quantité ou appliquer un facteur. Diviser signifie partager ou rapporter une grandeur à une autre. Les symboles se lisent respectivement « plus », « moins », « multiplié par » et « divisé par ».
Une expression contenant plusieurs opérations n’est pas calculée de gauche à droite sans règle. On traite d’abord les parenthèses, puis les puissances, ensuite multiplications et divisions, enfin additions et soustractions. Multiplication et division ont la même priorité et se traitent de gauche à droite ; même principe pour addition et soustraction.
3 + 4 × 5
La multiplication est prioritaire : 4 × 5 = 20.
On additionne ensuite : 3 + 20 = 23.
Si l’on voulait additionner d’abord, il faudrait écrire (3 + 4) × 5 = 7 × 5 = 35. Les parenthèses changent donc le calcul.
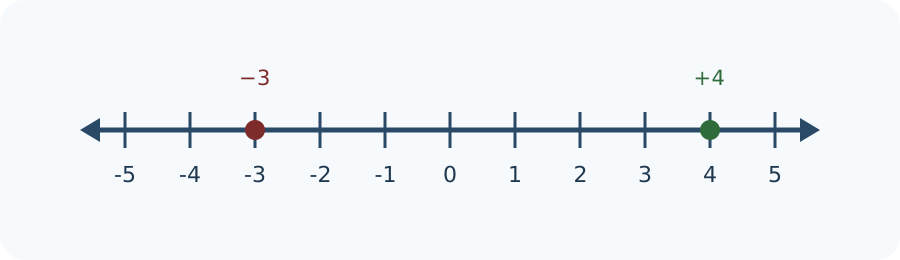
Les nombres négatifs servent à représenter une variation opposée, un solde déficitaire ou une position sous une référence. Sur une droite graduée, −3 est trois unités à gauche de zéro ; +4 est quatre unités à droite. Soustraire un nombre négatif revient à ajouter son opposé : 10 − (−3) = 13.
La droite graduée permet de visualiser signe, ordre et distance à zéro.Exercice corrigé — priorités et signe
Calculer 12 − 2 × (3 + 1).
Parenthèses : 3 + 1 = 4.
Multiplication : 2 × 4 = 8.
Soustraction : 12 − 8 = 4.
Contrôle : si vous obtenez 40, vous avez additionné ou multiplié dans le mauvais ordre.
Pourquoi ces priorités existent-elles ?
Les ne sont pas une convention arbitraire destinée à piéger l’élève. Elles permettent à deux personnes de lire la même expression sans ambiguïté. Dans un tableur, un logiciel statistique ou une formule budgétaire, l’absence de parenthèses peut modifier le résultat de manière spectaculaire. Écrire la structure avant de taper les nombres est donc une compétence de contrôle.
La division mérite une vigilance supplémentaire. Dans 24 ÷ 6 × 2, division et multiplication ont la même priorité ; on lit de gauche à droite : 24 ÷ 6 = 4, puis 4 × 2 = 8. Si l’intention était de diviser 24 par le produit 6×2, il fallait écrire 24 ÷ (6×2) = 2. Une parenthèse n’est pas décorative : elle annonce quelle quantité forme un bloc.
Calcul mental utile : avant toute calculatrice, estimez. 19×51 est proche de 20×50=1 000. Si la machine affiche 96,9 ou 9 690, l’ordre de grandeur signale immédiatement une saisie ou une unité à revoir.
2. Position des chiffres, notation scientifique et ordres de grandeur
Un millier vaut 1 000 = 10³ ; un million vaut 1 000 000 = 10⁶ ; un milliard vaut 1 000 000 000 = 10⁹. L’exposant indique combien de facteurs 10 sont multipliés. « 10 puissance 6 » signifie 10 × 10 × 10 × 10 × 10 × 10.
La notation scientifique écrit un nombre sous la forme a × 10ⁿ avec 1 ≤ a < 10. Ainsi 3 200 000 = 3,2 × 10⁶. Elle aide à comparer rapidement des ordres de grandeur et à repérer un facteur mille oublié.
3,2 × 10¹² ÷ (8 × 10⁶)
Diviser les coefficients : 3,2 ÷ 8 = 0,4.
Diviser les puissances de dix revient ici à soustraire les exposants : 10¹² ÷ 10⁶ = 10⁶.
On obtient 0,4 × 10⁶.
Pour remettre le coefficient entre 1 et 10 : 0,4 × 10⁶ = 4 × 10⁵ = 400 000.
Le contrôle mental d’ordre de grandeur précède la calculatrice. Si environ 300 milliards d’euros sont répartis entre environ 70 millions de personnes, 300÷70 est un peu supérieur à 4 et le rapport des unités « milliard / million » ajoute un facteur mille : on attend quelques milliers d’euros par personne, pas quelques euros.
Exercice corrigé — millions et milliards
Convertir 450 millions d’euros en milliards.
1 milliard = 1 000 millions.
450 ÷ 1 000 = 0,45.
Réponse : 450 M€ = 0,45 Md€ ; l’unité change mais la valeur économique reste la même.
Changer d’échelle sans changer de réalité
Les débats économiques mélangent souvent euros, milliers d’euros, millions et milliards. Pour sécuriser une conversion, écrivez l’égalité d’unités : 1 Md€ = 1 000 M€. Ainsi 3,6 Md€ = 3 600 M€. Dans l’autre sens, 75 M€ = 75 ÷ 1 000 = 0,075 Md€. Le déplacement de virgule ne doit jamais être fait sans nommer l’unité de départ et l’unité d’arrivée.
Les préfixes peuvent aussi concerner l’énergie : 1 GWh = 1 000 MWh et 1 TWh = 1 000 GWh. Le même facteur mille apparaît, mais l’objet mesuré n’est plus monétaire. Le contrôle d’unité empêche de comparer directement « 10 Md€ » et « 10 TWh » comme si les nombres avaient le même sens.
Une estimation de type Fermi consiste à décomposer une question inconnue en quelques ordres de grandeur connus. Pour estimer un coût national, on peut multiplier coût par bénéficiaire × nombre de bénéficiaires × fréquence. L’objectif n’est pas la précision finale, mais la capacité à repérer si l’on parle plutôt de millions, de milliards ou de dizaines de milliards.
3. Fractions, ratios, règle de trois et proportionnalité
Une fraction a un numérateur et un dénominateur. Dans 3/4, on lit « trois quarts » : trois parts sont retenues sur quatre parts égales. Diviser 3 par 4 donne 0,75. Une fraction n’est donc pas seulement une écriture scolaire : c’est un rapport.
Un doit toujours annoncer son sens. « Dette / PIB » n’est pas « PIB / dette ». Le numérateur est ce que l’on rapporte ; le dénominateur est la référence. Lorsque les unités sont identiques, elles peuvent se simplifier et donner un nombre sans unité ; lorsqu’elles diffèrent, l’unité du ratio doit être conservée, par exemple « euros par habitant ».
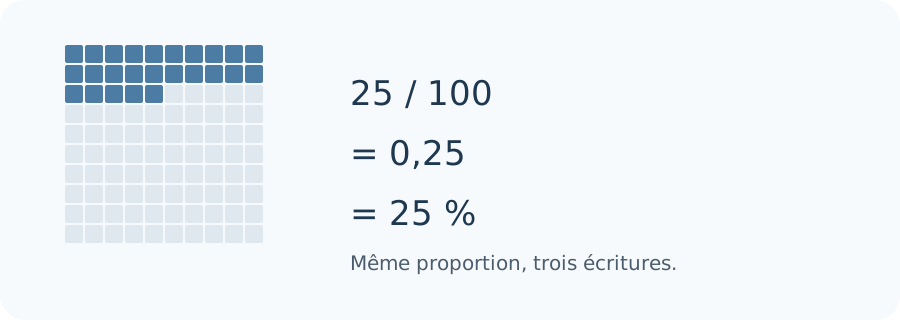
Une même proportion peut s’écrire en fraction, en décimal ou en pourcentage.
La sert quand deux grandeurs sont proportionnelles. Si 8 objets coûtent 24 €, le prix de 1 objet est 24 ÷ 8 = 3 €, puis 15 objets coûtent 15 × 3 = 45 €. Cette méthode est plus sûre que mémoriser un produit en croix sans comprendre les unités.
Une dépense vaut 140 Md€ pour 70 millions de personnes. Calculer un montant par personne.
140 Md€ = 140 000 M€ ; 70 millions = 70 M de personnes.
140 000 M€ ÷ 70 M personnes = 2 000 € par personne.
Les « millions » se simplifient ; l’unité finale est bien euros par personne.
Simplifier, inverser et comparer des fractions
Simplifier 12/18 consiste à diviser numérateur et dénominateur par un même facteur non nul : 12÷6 = 2 et 18÷6 = 3, donc 12/18 = 2/3. La valeur du ratio ne change pas. Cette propriété est utile lorsqu’un ratio économique contient des unités communes que l’on peut réduire.
Inverser une fraction change sa question : l’inverse de 2/5 est 5/2. Si 2 travailleurs produisent 5 unités, « unités par travailleur » vaut 5/2 = 2,5 ; « travailleurs par unité » vaut 2/5 = 0,4. Ce sont deux indicateurs cohérents mais différents. Le cours sur le commerce international utilise exactement cette vigilance pour ne pas inverser un .
Pour comparer 3/7 et 4/9 sans calculatrice, on peut utiliser un produit croisé : 3×9 = 27 et 4×7 = 28 ; 3/7 est donc légèrement inférieur à 4/9. Cette technique fonctionne parce que les dénominateurs sont positifs et évite des décimales arrondies trop tôt.
4. Pourcentages, points de pourcentage, coefficients multiplicateurs et pondération
« Pour cent » signifie « sur cent ». 7 % = 7/100 = 0,07. Pour calculer 7 % de 250, on multiplie 0,07 × 250 = 17,5. Pour retrouver le taux à partir d’une part, on divise la part par le total puis on multiplie par 100.
Un point de pourcentage est une différence entre deux taux. Passer de 20 % à 22 % représente +2 points de pourcentage. La hausse relative du taux est cependant (22−20)÷20 = 2÷20 = 0,10 = +10 %. Dire « +2 % » serait ambigu et souvent faux.
Le permet d’appliquer directement une variation. Une hausse de 5 % correspond à ×1,05 ; une baisse de 5 % à ×0,95. Pour revenir en arrière, on ne multiplie pas par l’opposé : on divise par le coefficient initial.
valeur finale = valeur initiale × (1 + taux)
Une valeur de 200 augmente de 12 % : 12 % = 0,12.
Coefficient = 1 + 0,12 = 1,12.
Valeur finale = 200 × 1,12 = 224.
Contrôle : 12 % de 200 = 24 ; 200 + 24 = 224.
Une attribue à chaque valeur un poids. Si 60 % d’un portefeuille rapporte 8 % et 40 % rapporte 3 %, le rendement pondéré vaut 0,60×8 + 0,40×3 = 6 %. Les poids doivent être exprimés dans une convention cohérente et leur somme vaut généralement 1 ou 100 %.
Exercice corrigé — variations successives
Partir de 100, appliquer +10 %, puis −10 %.
Après +10 % : 100 × 1,10 = 110.
Après −10 % : 110 × 0,90 = 99.
Le résultat n’est pas 100 car la baisse de 10 % s’applique à une base de 110. Deux variations opposées de même taux ne s’annulent donc pas.
Taux, base de comparaison et élasticité intuitive
Une variation relative n’a de sens qu’avec une base clairement annoncée. Une hausse de 20 à 30 vaut +10 en niveau, +50 % relativement à 20, mais 30 représente 150 % de la valeur initiale. Ces trois phrases sont compatibles ; elles répondent simplement à des questions différentes.
Pour retrouver une valeur initiale après hausse, on divise par le coefficient multiplicateur. Si un prix final de 126 € résulte d’une hausse de 5 %, le prix initial vaut 126 ÷ 1,05 = 120 €. Soustraire 5 % de 126 donnerait 119,70 € et serait faux, car la base du 5 % n’est plus la même.
L’idée d’élasticité généralise une comparaison de pourcentages : variation en % d’une quantité divisée par variation en % d’une autre. Si un prix augmente de 5 % et une demande baisse de 10 %, l’élasticité signée simplifiée vaut −10 % ÷ 5 % = −2. Le signe donne le sens ; la valeur absolue indique l’intensité de réaction.
5. Algèbre : inconnues, équations, puissances, racines et notation symbolique
Une est une grandeur qui peut changer ; une inconnue est la valeur que l’on cherche ; un est une valeur fixée dans un ou un scénario. Résoudre une équation consiste à conserver l’égalité en faisant la même opération des deux côtés.
Le symbole ² se lit « au carré » : 5² = 5×5 = 25. Une , notée √, effectue l’opération inverse pour un carré positif : √25 = 5. Ce couple apparaîtra dans la et l’écart-type.
Les lettres grecques sont courantes en économie. α se lit « alpha », β « bêta », Δ « delta » et Σ « sigma ». Delta signale souvent une variation ; sigma majuscule ordonne de sommer plusieurs termes. Un indice comme i dans xᵢ se lit « x indice i » et sert à numéroter une observation, une entreprise ou un scénario.
Exercice corrigé — sigma et indice
Calculer Σ xᵢ pour x₁=2, x₂=5 et x₃=7.
Σ signifie additionner les valeurs indexées.
Σ xᵢ = x₁ + x₂ + x₃ = 2 + 5 + 7 = 14.
L’indice i ne se multiplie pas par x : il sert seulement à identifier les termes de la série.
Transposer une formule sans perdre le sens économique
Isoler une variable n’est pas un jeu abstrait. Si R = t×B et que l’on connaît R et B, on peut retrouver t en divisant les deux côtés par B : t = R÷B. Si R=200 € et B=1 000 €, alors t=0,20=20 %. L’algèbre permet ainsi de transformer une relation selon la grandeur recherchée.
Un exposant négatif représente un inverse : x⁻¹ = 1/x. Un exposant fractionnaire peut représenter une racine : x^(1/2)=√x pour x positif. Ces écritures apparaissent dans certaines fonctions de production et certains calculs financiers. Le cours doit toujours privilégier la lecture en mots lorsqu’elles sont introduites.
Une équation peut avoir aucune, une ou plusieurs solutions selon sa forme. Dans les cours introductifs, on utilise surtout des relations linéaires où isoler l’inconnue suffit. Plus tard, un modèle peut contenir plusieurs équations et plusieurs inconnues ; l’idée fondamentale reste de respecter simultanément toutes les relations annoncées.
6. Fonctions, axes, pente, variation marginale et idée de dérivée
Une fonction associe une sortie à une entrée. Écrire y = f(x) se lit « y égale f de x » : la valeur de y dépend de x selon une règle. Sur un graphique, l’axe horizontal est souvent x et l’axe vertical y, mais il faut toujours lire les étiquettes plutôt que supposer.
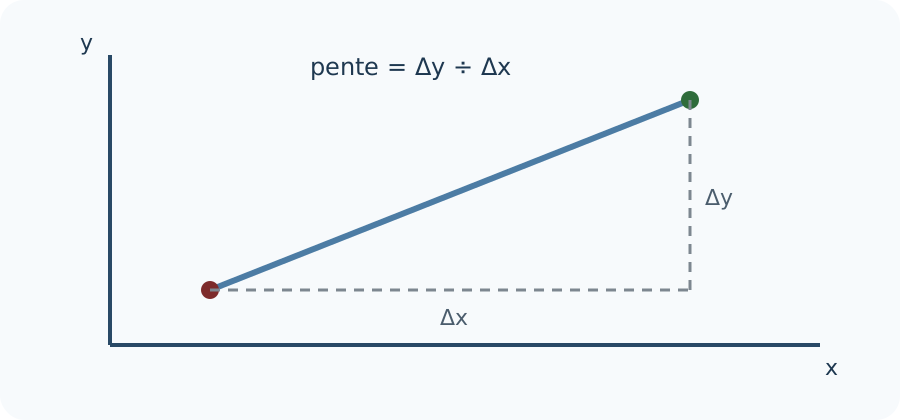
La pente compare une variation verticale à une variation horizontale : pente = Δy ÷ Δx. Le symbole Δ se lit « delta » et signifie variation. Une pente de 2 signifie que y augmente d’environ 2 unités lorsque x augmente d’une unité sur le segment considéré.
La pente est un rapport de variations : Δy ÷ Δx.
pente = (y₂ − y₁) ÷ (x₂ − x₁)
Point 1 : x₁=2, y₁=5. Point 2 : x₂=6, y₂=13.
Δy = 13 − 5 = 8.
Δx = 6 − 2 = 4.
Pente = 8 ÷ 4 = 2 unités de y par unité de x.
La généralise cette idée quand on rapproche les deux points jusqu’à mesurer un taux de variation local. Dans une fonction de coût, un peut être interprété comme la variation du coût pour une très petite variation de quantité. Vous n’avez pas besoin de calcul différentiel avancé pour suivre l’École, mais vous devez comprendre cette intuition.
Exercice corrigé — pente négative
La quantité demandée passe de 80 à 60 quand le prix passe de 10 € à 20 €. Calculer la pente quantité/prix.
ΔQ = 60 − 80 = −20 unités.
ΔP = 20 − 10 = +10 €.
Pente = −20 ÷ 10 = −2 unités par euro. Le signe négatif indique que les deux variables évoluent ici en sens opposé.
Niveau, variation, pente moyenne et variation locale
Une courbe peut monter tout en restant négative, ou descendre tout en restant positive. C’est pourquoi « niveau » et « variation » ne sont jamais synonymes. Un déficit passant de −100 à −60 s’améliore de +40 même s’il reste négatif. Une dette passant de 3 000 à 3 100 augmente même si le déficit annuel diminue.
La pente entre deux points est une variation sur un intervalle. La dérivée cherche la pente locale lorsque l’intervalle devient très petit. Dans un graphique coût-quantité, une pente croissante signifie que produire des unités supplémentaires devient de plus en plus coûteux localement ; c’est l’intuition du coût marginal croissant.
Attention aux axes logarithmiques, aux axes tronqués et aux doubles axes verticaux. Un graphique peut être exact numériquement tout en donnant une impression visuelle trompeuse. Avant de lire la forme, identifiez origine de l’axe, pas de graduation, unité, fréquence temporelle et éventuelle rupture de série.
7. Croissance composée, logarithmes et actualisation
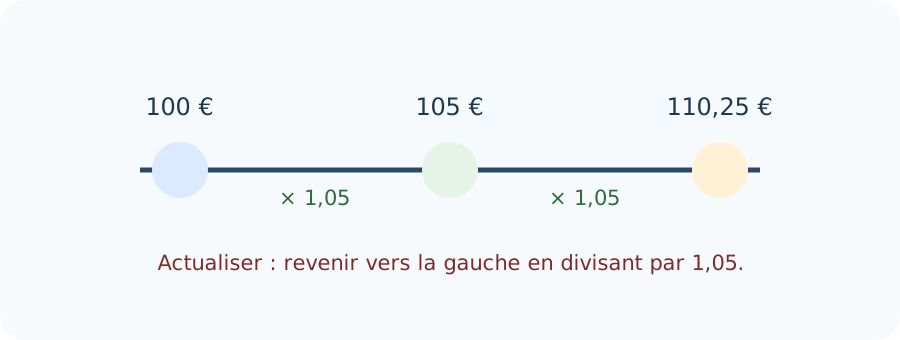
Une croissance composée applique le taux à la nouvelle base à chaque période. À 5 % par an, 100 € deviennent 105 € après un an, puis 105×1,05 = 110,25 € après deux ans. La formule compacte est VF = VP×(1+r)ⁿ.
Capitaliser va vers le futur par multiplication ; actualiser revient au présent par division.
VP = VF ÷ (1 + r)ⁿ
Symbole
Lecture
Unité
VP
valeur présente
€ aujourd’hui
VF
valeur future
€ à la date future
r
taux par période
nombre décimal
n
nombre de périodes
années, mois ou autre période cohérente
VF = 110,25 €, r = 5 % = 0,05, n = 2.
1+r = 1,05.
1,05² = 1,1025.
VP = 110,25 ÷ 1,1025 = 100 €.
Le est l’opération inverse d’une exponentielle. Si 2³ = 8, alors le logarithme en base 2 de 8 vaut 3. Le logarithme naturel, noté ln, est très utilisé pour transformer des produits en sommes et approximer des taux de croissance. Dans ce parcours, toute utilisation avancée de ln devra rappeler cette définition.
Exercice corrigé — doublement
Une quantité croît de 2 % par an. Écrire sa valeur après trois ans si elle vaut 1 000 au départ.
2 % = 0,02 ; coefficient annuel = 1,02.
Après trois ans : 1 000 × 1,02³.
1,02² = 1,0404 ; 1,0404×1,02 = 1,061208.
Valeur ≈ 1 061,21. La hausse totale est environ 6,12 %, pas exactement 6 %, à cause de la composition.
Taux nominal, taux réel et temps de doublement
Une hausse nominale ne dit pas combien le pouvoir d’achat a changé. Si un revenu augmente de 5 % tandis que les prix augmentent de 3 %, l’approximation du gain réel est environ 2 points. Le calcul exact est 1,05÷1,03−1 ≈ 1,94 %. L’écart entre approximation et calcul exact reste faible ici mais peut devenir important pour des taux élevés.
Le logarithme naturel permet aussi d’additionner approximativement des taux de croissance continus et de transformer une croissance multiplicative en relation additive. À ce stade, retenez surtout l’idée inverse : exponentier fait croître par multiplication répétée ; logarithmer demande quel exposant aurait produit le rapport observé.
Une règle mentale souvent appelée « règle de 70 » donne un temps de doublement approximatif : 70 divisé par le taux annuel en pourcentage. À 2 %, environ 35 ans ; à 5 %, environ 14 ans. C’est une estimation, pas un substitut au calcul composé exact.
8. Statistiques descriptives : moyenne, médiane, quantiles et moyenne pondérée
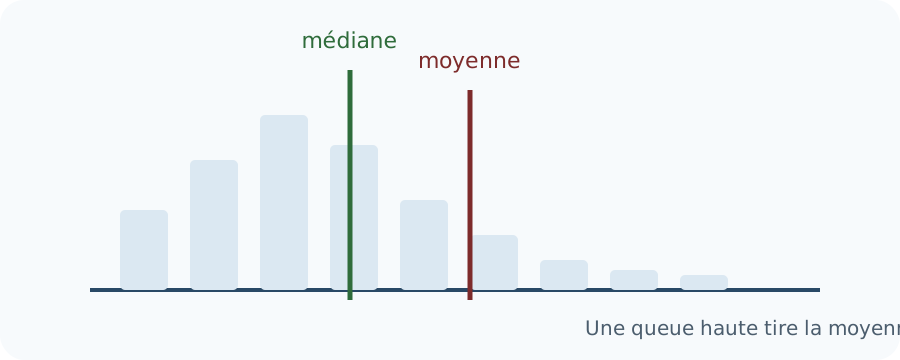
La moyenne arithmétique additionne les observations puis divise par leur nombre. Pour 2, 3 et 10 : (2+3+10)÷3 = 5. La médiane est la valeur centrale après classement : ici 3. Une valeur extrême peut déplacer fortement la moyenne sans déplacer autant la médiane.
Dans une distribution asymétrique, moyenne et médiane répondent à des questions différentes.
Pour un nombre pair d’observations, la médiane usuelle est la moyenne des deux valeurs centrales. Pour 1, 2, 3, 20, les deux valeurs centrales sont 2 et 3 ; médiane = (2+3)÷2 = 2,5 tandis que la moyenne vaut 6,5.
Un quantile est une coupure dans une distribution ordonnée. Les quartiles découpent en quatre groupes ; les déciles en dix ; les centiles en cent. Les méthodes institutionnelles peuvent différer légèrement pour les petites séries, donc il faut suivre la convention de la source.
moyenne pondérée = Σ(wᵢ × xᵢ) ÷ Σwᵢ
« sigma de w indice i multiplié par x indice i, divisé par sigma des poids ». Si les poids sont des parts qui totalisent 1, le dénominateur vaut 1.
Valeurs 8 et 3 avec poids 0,60 et 0,40.
0,60×8 = 4,8 ; 0,40×3 = 1,2.
Somme = 6. Les poids totalisent 1.
Moyenne pondérée = 6.
Choisir un indicateur de position selon la question
La moyenne répond à la question « quelle valeur obtiendrait chacun si le total était réparti également ? ». La médiane répond à « quelle valeur partage la série ordonnée en deux moitiés ? ». Pour des revenus très asymétriques, la médiane décrit souvent mieux la situation centrale d’une personne que la moyenne, tandis que la moyenne reste indispensable pour retrouver le total.
Un quantile n’est pas une moyenne de groupe. Le neuvième décile est un seuil : environ 90 % des observations sont en dessous selon la convention statistique. Le revenu moyen du décile supérieur est une autre grandeur. Confondre seuil et moyenne peut produire des comparaisons sociales absurdes.
Une moyenne pondérée doit annoncer ses poids. Pour une inflation agrégée, les catégories de dépenses n’ont pas toutes le même poids. Pour un portefeuille, les actifs ne contribuent pas également si leurs montants diffèrent. Sans poids, on calcule une moyenne simple qui répond à une autre question.
9. Dispersion : écarts, variance et écart-type calculés ligne par ligne
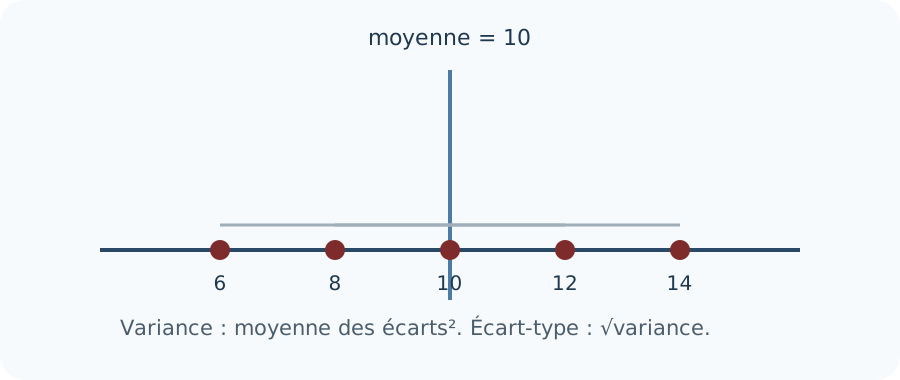
Deux séries peuvent avoir la même moyenne et des dispersions très différentes. Pour mesurer cette dispersion, on calcule d’abord l’écart de chaque observation à la moyenne. Les écarts positifs et négatifs s’annuleraient si on les additionnait directement ; on les met donc au carré dans la variance.
La variance met au carré les écarts ; l’écart-type revient dans l’unité d’origine par racine carrée.
variance population = Σ(xᵢ − μ)² ÷ N
Symbole
Lecture
Sens
Σ
sigma
additionner tous les termes
xᵢ
x indice i
observation i
μ
mu
moyenne de la population
²
au carré
multiplier l’écart par lui-même
N
N
nombre d’observations dans la population décrite
Série : 6, 8, 10, 12, 14. Moyenne μ = 10.
Écarts : −4, −2, 0, +2, +4.
Carrés : 16, 4, 0, 4, 16. Somme = 40.
Variance population = 40 ÷ 5 = 8 unités².
Écart-type = √8 ≈ 2,83 unités. La racine remet le résultat dans l’unité de la variable.
Pour un échantillon utilisé afin d’estimer une variance de population, une convention fréquente divise par n−1 plutôt que n. Le choix dépend de la question statistique. C’est précisément pourquoi une formule doit annoncer son cadre plutôt que montrer seulement des symboles.
Exercice corrigé — variance simple
Série population : 2, 4, 6.
Moyenne μ = (2+4+6)÷3 = 4.
Écarts : −2, 0, +2. Carrés : 4, 0, 4.
Somme des carrés = 8. Variance population = 8÷3 ≈ 2,67.
Écart-type = √2,67 ≈ 1,63.
Pourquoi mettre les écarts au carré ?
Les écarts à la moyenne ont une propriété : leur somme vaut zéro lorsque chaque observation a le même poids. Les additionner ne mesure donc pas la dispersion. Les mettre au carré rend tous les termes positifs et donne davantage de poids aux grands écarts. On pourrait utiliser la valeur absolue, mais la variance possède des propriétés algébriques particulièrement utiles.
L’écart-type est la racine carrée de la variance. Si la variable est en euros, la variance est en euros carrés, unité difficile à interpréter ; la racine ramène l’écart-type en euros. Dire « écart-type de 200 € » devient immédiatement lisible.
Un écart-type n’est pas une garantie de plage. Pour une distribution approximativement normale, des règles de proportion autour de la moyenne peuvent être utiles, mais les rendements financiers, dépenses de santé ou sinistres peuvent avoir des queues épaisses. Toujours examiner la forme de la distribution avant d’appliquer une règle automatique.
10. Probabilités simples, conditionnelles, indépendance et arbre de calcul
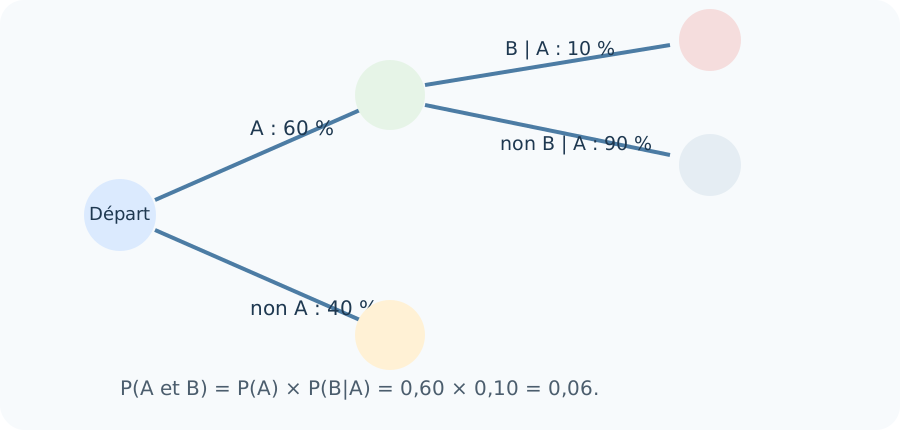
Une probabilité vaut entre 0 et 1, soit entre 0 % et 100 %. Une probabilité de 0,20 se lit 20 %. La probabilité conditionnelle P(B|A) se lit « probabilité de B sachant A » : on restreint la référence aux situations où A est déjà réalisé.
Dans un chemin d’arbre, on multiplie les probabilités conditionnelles successives.
P(A et B) = P(A) × P(B|A)
P(A)=60 %=0,60.
P(B|A)=10 %=0,10.
P(A et B)=0,60×0,10=0,06.
0,06=6 %. Sur 10 000 cas comparables, l’ordre de grandeur attendu serait 600 cas du chemin A puis B, sans garantie d’obtenir exactement 600.
Deux événements sont indépendants si connaître A ne change pas la probabilité de B dans le modèle, donc P(B|A)=P(B). Cette hypothèse est forte. En économie et en assurance, de nombreux événements sont conditionnés par âge, revenu, secteur, conjoncture ou comportement.
Exercice corrigé — Bayes intuitif
1 % d’une population a une caractéristique. Un test est positif dans 90 % des cas ayant la caractéristique et dans 5 % des cas ne l’ayant pas. Sur 10 000 personnes, compter les positifs vrais et faux.
Caractéristique : 1 % de 10 000 = 100 personnes. Positifs vrais : 90 % de 100 = 90.
Sans caractéristique : 9 900 personnes. Faux positifs : 5 % de 9 900 = 495.
Total positifs = 90 + 495 = 585.
Parmi les positifs, la part ayant réellement la caractéristique est 90÷585 ≈ 15,4 %. Le faible taux de base change radicalement l’interprétation du test.
Fréquence observée, probabilité de modèle et taux de base
Une fréquence observée est un nombre calculé sur des données passées ; une probabilité est une description de l’incertitude dans un modèle ou une situation. Les deux peuvent être reliées, mais elles ne sont pas identiques. Une fréquence passée de 2 % n’impose pas que la probabilité future soit exactement 2 % si le contexte change.
Le taux de base est la fréquence initiale de l’événement avant une information supplémentaire. L’exercice du test montre pourquoi un test très sensible peut produire beaucoup de faux positifs lorsque l’événement de départ est rare. Cette intuition est essentielle pour lire risques médicaux, fraude, défaut de crédit ou alertes de sécurité.
Pour deux événements incompatibles, P(A ou B)=P(A)+P(B). S’ils peuvent se produire ensemble, il faut retrancher l’intersection : P(A ou B)=P(A)+P(B)−P(A et B). Oublier ce terme compterait deux fois les cas communs.
11. Covariance, corrélation, nuage de points, droite de régression et résidu
La regarde si les écarts de X à sa moyenne et de Y à sa moyenne ont tendance à avoir le même signe. Une covariance positive signifie que les valeurs au-dessus de la moyenne de X sont souvent associées à des valeurs au-dessus de la moyenne de Y ; une covariance négative suggère l’inverse. Sa magnitude dépend des unités.
La normalise cette relation entre −1 et +1. +1 indique une relation linéaire positive parfaite, −1 une relation linéaire négative parfaite, 0 l’absence de relation linéaire. Zéro corrélation ne signifie pas absence de toute relation ; une relation courbe peut exister.
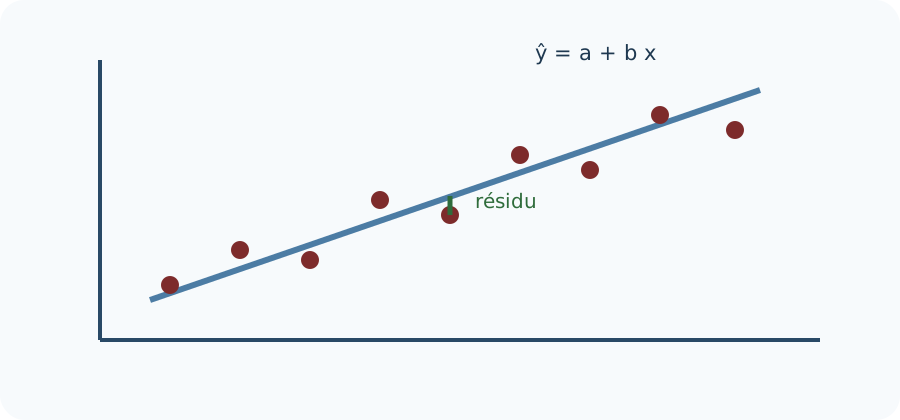
La droite résume une tendance ; le résidu est l’écart entre observation et valeur prédite.
ŷᵢ = a + b xᵢ ; eᵢ = yᵢ − ŷᵢ
Symbole
Lecture
Sens
ŷᵢ
y chapeau indice i
valeur prédite de Y pour l’observation i
a
a
constante ou intercept
b
b
pente estimée
xᵢ
x indice i
valeur de X
eᵢ
e indice i
résidu = observé − prédit
Supposons ŷ = 2 + 3x.
Pour x=4, valeur prédite ŷ = 2 + 3×4 = 14.
Si y observé vaut 16, résidu e = 16 − 14 = 2.
Le résidu ne prouve pas que le modèle est « faux » : il mesure ce que cette relation n’explique pas pour cette observation.
Une régression n’établit pas automatiquement une causalité. Une variable omise, une causalité inverse, une sélection ou une tendance commune peuvent produire une association. L’étape experte consiste à expliquer pourquoi la variation utilisée permettrait, ou non, une interprétation causale.
Standardiser la covariance et ne pas confondre prédiction et causalité
La covariance change si l’on mesure un revenu en euros plutôt qu’en milliers d’euros. La corrélation divise la covariance par les écarts-types de X et Y, ce qui produit un nombre sans unité entre −1 et +1. Cette standardisation facilite les comparaisons mais ne rend pas la relation causale.
Dans une régression simple, le coefficient b mesure la variation moyenne prédite de Y associée à une unité supplémentaire de X selon le modèle. Si X est en années et Y en euros, b s’exprime en euros par année. L’unité du coefficient est un contrôle puissant contre les interprétations fantaisistes.
Le résidu contient tout ce que le modèle ne prédit pas pour une observation : bruit, variables omises, mesure imparfaite, non-linéarité. Un bon modèle ne cherche pas à faire disparaître artificiellement tous les résidus ; il cherche à expliquer ce que signifie leur structure.
12. Échantillon, erreur standard, intervalle de confiance, hypothèse nulle et p-value
Une statistique calculée sur un échantillon varie d’un échantillon à l’autre. L’erreur standard mesure cette variabilité d’estimation sous un modèle d’échantillonnage. Elle n’est pas l’écart-type des individus : l’écart-type décrit la dispersion des observations ; l’erreur standard décrit l’incertitude d’une estimation.
Un à 95 % n’est pas, dans l’interprétation fréquentiste classique, « une probabilité de 95 % que le paramètre soit dans cet intervalle » après calcul. Il vient d’une procédure qui, répétée un grand nombre de fois sous les hypothèses du modèle, produirait des intervalles couvrant le paramètre dans environ 95 % des répétitions.
IC approximatif 95 % : estimation ± 1,96 × erreur standard
Estimation = 2,0 ; erreur standard = 0,5.
1,96×0,5 = 0,98.
Borne basse = 2,0 − 0,98 = 1,02.
Borne haute = 2,0 + 0,98 = 2,98.
Intervalle approximatif : [1,02 ; 2,98], sous les conditions justifiant cette approximation.
Un test commence par une hypothèse nulle H₀, par exemple « l’effet vaut zéro ». On choisit une statistique de test et on étudie sa distribution si H₀ et les hypothèses du modèle sont vraies. La est la probabilité, sous ce cadre, d’obtenir une statistique au moins aussi extrême que celle observée.
Une p-value de 0,03 ne signifie ni « 3 % de chances que H₀ soit vraie », ni « 97 % de chances que l’effet soit réel », ni « effet important ». Elle indique que, sous H₀ et le modèle de test, un résultat au moins aussi extrême aurait une probabilité de 3 %. Taille de l’effet, intervalle de confiance, puissance, qualité des données, choix du modèle et multiplicité des tests restent nécessaires.
Exercice corrigé — p-value et intervalle
Une estimation vaut 1,5 avec erreur standard 0,4. Construire un IC approximatif à 95 %.
1,96×0,4 = 0,784.
Borne basse = 1,5 − 0,784 = 0,716.
Borne haute = 1,5 + 0,784 = 2,284.
L’intervalle approximatif [0,716 ; 2,284] n’inclut pas zéro. Cela peut correspondre à un test bilatéral au seuil de 5 % dans ce cadre simple, mais il faut encore vérifier hypothèses, taille d’échantillon, construction de l’erreur standard et question substantielle.
Échantillonnage, précision et importance substantielle
Une grande taille d’échantillon réduit souvent l’erreur standard, toutes choses égales par ailleurs. Cela signifie qu’un effet minuscule peut devenir statistiquement très précisément estimé. « Statistiquement significatif » ne signifie donc pas « économiquement important ». Il faut lire la taille de l’effet et son unité.
Le seuil de 5 % n’est pas une frontière naturelle entre vrai et faux. Une p-value de 0,049 et une de 0,051 apportent des informations très proches ; les traiter comme des verdicts opposés est une mauvaise pratique. Présenter estimation, intervalle et contexte est plus informatif qu’un simple astérisque.
Les tests multiples augmentent la probabilité d’obtenir au moins un résultat extrême par hasard. Si l’on teste vingt hypothèses sans correction ni plan préalable, un résultat isolé à p<0,05 mérite davantage de prudence. Cette idée prépare à la lecture critique des études empiriques.
Erreurs fréquentes à éliminer avant le cours 1
Calculer sans écrire l’unité ou la période.
Confondre une hausse de 2 % avec une hausse de 2 points de pourcentage.
Inverser un ratio sans reformuler la question en mots.
Appliquer +x % puis −x % en pensant revenir automatiquement au point de départ.
Lire un graphique sans regarder l’échelle des axes.
Présenter une corrélation comme une causalité.
Confondre écart-type des observations et erreur standard d’une estimation.
Interpréter une p-value comme la probabilité que l’hypothèse nulle soit vraie.
Arrondir trop tôt et accumuler les erreurs dans un calcul en plusieurs étapes.
Si l’une de ces erreurs vous paraît encore possible, refaites l’exercice correspondant en expliquant chaque étape à voix haute. Être capable d’expliquer lentement vaut mieux que calculer vite sans savoir ce que l’on mesure.
13. Évaluation cumulative : prouver que vous savez reconstruire le raisonnement
Ne cherchez pas seulement le résultat. Pour chaque exercice, écrivez : données → unités → formule ou règle → calcul ligne par ligne → contrôle mental → interprétation → limite.
Priorités : calculer 20 − 3×(4+2). Correction
4+2=6.
3×6=18.
20−18=2.
Proportion : 35 % de 240 ? Correction
35 %=0,35.
0,35×240=84.
Réponse : 84 unités.
Points : un taux passe de 8 % à 10 %. Correction
Écart en points : 10−8=2 points de pourcentage.
Hausse relative : (10−8)÷8=0,25=25 %.
Les deux mesures répondent à des questions différentes.
Algèbre : résoudre 5x−7=18. Correction
Ajouter 7 : 5x=25.
Diviser par 5 : x=5.
Vérifier : 5×5−7=18.
Pente : de (2,5) à (6,13). Correction
Δy=13−5=8.
Δx=6−2=4.
Pente=8÷4=2.
Variance : population 2,4,6. Correction
Moyenne=4.
Écarts : −2,0,+2 ; carrés : 4,0,4.
Variance=8÷3≈2,67.
Écart-type≈√2,67≈1,63.
Probabilité : P(A)=0,4 et P(B|A)=0,25. P(A et B) ? Correction
0,4×0,25=0,10.
Réponse : 10 %.
Régression : ŷ=5+2x, x=3, y observé=13. Correction
Prédiction : ŷ=5+2×3=11.
Résidu : e=y−ŷ=13−11=2.
IC : estimation 4, erreur standard 1. Correction
Marge≈1,96×1=1,96.
IC≈[4−1,96 ; 4+1,96]=[2,04 ; 5,96].
Interpréter comme résultat de procédure sous hypothèses, pas comme probabilité directe sur le paramètre.
Critère de passage : vous êtes prêt pour le cours 1 si vous savez expliquer pourquoi chaque opération est autorisée et dans quelle unité se lit le résultat. Si un symbole vous bloque, utilisez le glossaire contextuel ou revenez au chapitre correspondant : l’objectif est l’autonomie, pas la vitesse.
14. Cas cumulatifs — passer des outils isolés à un raisonnement complet
Un économiste n’utilise presque jamais une seule opération. Les quatre dossiers suivants combinent proportions, pourcentages, unités, statistiques et lecture critique. Le but est de rendre chaque ligne reproductible avec une calculatrice ordinaire, puis de distinguer ce que le calcul établit de ce qu’il ne peut pas établir.
Cas A — passer d’un budget total à un coût par habitant et à une part du PIB
Données : Un programme coûte 51 Md€ pour 68 millions d’habitants. Le PIB nominal vaut 3 000 Md€. L’année suivante, le programme augmente de 3,5 % et le PIB de 2 %.
Déplier le raisonnement complet
Mettre les grandeurs sur une même échelle. 51 Md€ = 51 000 M€. La population est 68 millions de personnes.
Coût par habitant : 51 000 M€ ÷ 68 M personnes = 750 € par personne. Les « millions » se simplifient dans le ratio.
Part initiale du PIB : 51 ÷ 3 000 = 0,017. Puis 0,017 × 100 = 1,70 % du PIB.
Budget de l’année suivante : coefficient multiplicateur = 1 + 3,5/100 = 1,035. Donc 51 × 1,035 = 52,785 Md€.
Nouvelle part : 52,785 ÷ 3 060 × 100 = 1,725 %, soit environ 1,73 %. Le budget augmente plus vite que le PIB : sa part du PIB progresse légèrement.
Variation en points : 1,725 − 1,700 = +0,025 point de PIB. Cette écriture est différente de +0,025 % : un point de pourcentage mesure l’écart entre deux taux.
Contrôle de cohérence : 750 € × 68 millions = 51 Md€ : la multiplication inverse reconstruit le montant de départ. De même, 1,725 % de 3 060 Md€ redonne environ 52,785 Md€.
Limite d’interprétation : Un coût moyen par habitant ne dit rien sur qui paie réellement, qui bénéficie du programme, sa distribution territoriale ou son effet causal. La part du PIB est un ratio de taille, pas une évaluation d’efficacité.
Cas B — moyenne, médiane, variance et écart-type sur une petite distribution
Données : Cinq revenus mensuels valent 1 500 €, 1 600 €, 1 700 €, 1 800 € et 5 400 €. On traite ici ces cinq observations comme la population complète du petit exemple.
Médiane : les valeurs sont déjà ordonnées ; la troisième est 1 700 €. La moyenne est donc 700 € au-dessus de la médiane à cause de la valeur élevée de 5 400 €.
Écarts à la moyenne : −900, −800, −700, −600 et +3 000 €.
Variance de population : 11 300 000 ÷ 5 = 2 260 000 €². L’unité est le carré de l’euro, ce qui rend la variance moins intuitive à lire directement.
Écart-type : √2 260 000 ≈ 1 503,33 €. La racine carrée ramène l’indicateur dans l’unité des revenus.
Si ces cinq valeurs n’étaient qu’un échantillon servant à estimer une variance de population, une convention fréquente diviserait par n − 1 = 4 plutôt que par 5. Il faut toujours annoncer la convention.
Contrôle de cohérence : La somme des écarts à la moyenne vaut −900 − 800 − 700 − 600 + 3 000 = 0. C’est une propriété utile pour détecter une erreur de calcul de la moyenne.
Limite d’interprétation : La moyenne et l’écart-type ne décrivent pas seuls toute la distribution. Avec des revenus très asymétriques, quantiles, médiane et éventuellement transformation logarithmique apportent une information complémentaire.
Cas C — erreur standard, intervalle de confiance et p-value sans formule magique
Données : Dans un échantillon aléatoire simple de 400 personnes, 208 répondent « oui », soit une proportion observée de 52 %. On veut quantifier l’incertitude d’échantillonnage et comparer ce résultat à une référence de 50 %.
Déplier le raisonnement complet
Proportion observée : p̂ = 208 ÷ 400 = 0,52. Le symbole p̂ se lit « p chapeau » et désigne ici la proportion estimée dans l’échantillon.
Erreur standard approximative d’une proportion : SE = √[p̂(1−p̂)/n]. Remplacer : SE = √[0,52 × 0,48 ÷ 400].
Produit : 0,52 × 0,48 = 0,2496. Division : 0,2496 ÷ 400 = 0,000624. Racine : √0,000624 ≈ 0,02498, soit environ 2,50 points de pourcentage.
Intervalle à 95 % selon l’approximation normale : p̂ ± 1,96 × SE. Marge = 1,96 × 0,02498 ≈ 0,04896.
Bornes : 0,52 − 0,04896 = 0,47104 et 0,52 + 0,04896 = 0,56896, soit environ [47,1 % ; 56,9 %].
Pour tester H0 : p = 0,50 avec cette approximation, calculer z = (0,52 − 0,50) ÷ 0,02498 ≈ 0,80. Une valeur de |z| proche de 0,8 n’est pas extrême sous une loi normale centrée ; la p-value bilatérale est d’environ 0,42.
Une p-value de 0,42 ne signifie pas « 42 % de chances que H0 soit vraie ». Elle mesure, sous H0 et sous le modèle de test, la fréquence d’un résultat au moins aussi éloigné de la référence que celui observé.
Contrôle de cohérence : La référence de 50 % appartient bien à l’intervalle approximatif [47,1 % ; 56,9 %]. Il serait incohérent d’annoncer simultanément que 50 % est exclu à 95 % avec les mêmes hypothèses.
Limite d’interprétation : Cette démonstration suppose notamment un échantillonnage compatible avec l’approximation utilisée. Un sondage biaisé, des non-réponses sélectives ou un plan complexe ne sont pas réparés par une petite erreur standard.
Cas D — construire une droite de régression et lire les résidus
Données : On observe quatre couples (x, y) : (1,2), (2,3), (3,5), (4,8). On ajuste à la main une droite y = a + b x par moindres carrés ordinaires.
Somme des carrés des écarts de x : 1,5² + 0,5² + 0,5² + 1,5² = 2,25 + 0,25 + 0,25 + 2,25 = 5.
Pente : b = 10 ÷ 5 = 2. Interception : a = ȳ − b x̄ = 4,5 − 2×2,5 = −0,5. La droite ajustée est donc ŷ = −0,5 + 2x.
Prédictions pour x = 1,2,3,4 : 1,5 ; 3,5 ; 5,5 ; 7,5. Les résidus y − ŷ valent +0,5 ; −0,5 ; −0,5 ; +0,5.
La somme des résidus vaut 0 dans cet exemple avec constante : 0,5 − 0,5 − 0,5 + 0,5 = 0. Cette propriété sert de contrôle arithmétique, pas de preuve que le modèle est causalement correct.
Contrôle de cohérence : La droite passe par le point moyen (x̄, ȳ) = (2,5 ; 4,5) : −0,5 + 2×2,5 = 4,5. Si ce contrôle échoue, la pente ou l’interception a été mal calculée.
Limite d’interprétation : Une pente de 2 ne signifie pas automatiquement que « +1 de x cause +2 de y ». Variables omises, causalité inverse, sélection et forme fonctionnelle peuvent produire une association sans effet causal.
Passage au niveau expert · méthode reproductible
De la compréhension au diagnostic : Ordres de grandeur, stocks et flux
À ce stade, l’objectif n’est plus de reconnaître le vocabulaire. Vous devez pouvoir reconstruire un raisonnement, vérifier les unités, identifier l’hypothèse décisive et expliquer ce qui ferait changer la conclusion. C’est cette discipline qui transforme une lecture économique en expertise utilisable.
1. Relation à savoir reconstruire
Variation (%) = (Vf − Vi) ÷ Vi × 100
Une dépense passe de 80 à 92 Md€ : la hausse est de 15 %, pas de 12 %.
Règle : ne retenez jamais une formule comme une incantation. Nommez chaque terme, son unité, sa période et le mécanisme économique qui relie les grandeurs.
2. Le piège qui fausse le plus souvent le débat
Toujours identifier unité, période, périmètre et nature stock/flux avant de calculer.
Avant d’accepter un chiffre, demandez toujours si le périmètre est constant, si l’on compare un niveau ou une variation, si le résultat est observé ou simulé et si une causalité est réellement démontrée.
3. Les données minimales à exiger
source primaire ou méthodologie identifiable ;
date et période exacte ;
unité, prix courants ou constants lorsque pertinent ;
population, assiette ou dénominateur ;
scénario de référence et hypothèses ;
ordre de grandeur permettant un contrôle mental.
4. Exercice de vérification
Une dette vaut 3 200 Md€ et le déficit annuel 120 Md€. Sans autre ajustement de stock, quel est le stock après deux ans ?
Voir la correction et le raisonnement
3 200 + 2 × 120 = 3 440 Md€. Le calcul est volontairement simplifié : en comptabilité réelle, des ajustements de stock peuvent intervenir.
Après le calcul, formulez la conclusion en une phrase puis ajoutez une seconde phrase indiquant la principale limite de l’exercice. Un économiste ne livre pas seulement un nombre : il explique à quelles conditions ce nombre a un sens.
Gate de maîtrise
5. Êtes-vous capable de contredire proprement une affirmation ?
Prenez une affirmation publique liée à ce thème et reconstruisez-la en cinq lignes : affirmation → données → formule ou mécanisme → résultat → incertitude. Si une de ces cinq lignes manque, vous n’avez pas encore une preuve complète. Si elles sont toutes présentes, essayez ensuite un scénario alternatif raisonnable et mesurez si la conclusion résiste.
Deux ouvrages pour approfondir le redressement de la France
Pour prolonger « Les finances publiques, du premier euro reçu aux intérêts de la dette », ces deux ouvrages développent le chiffrage, la consolidation des économies, les coûts de transition et la trajectoire complète de redressement des finances publiques.
Réforme de l’État — Plan de Rupture
Le dossier fondateur : finances publiques, structures, calendrier et mesures.